DGX Station GB300: Qwen3.8 und Qwen3.6 in BF16, FP8 und NVFP4
Viele Modelle mit offener Last werden in mehreren Genauigkeitsstufen veröffentlicht: die Originalversion BF16 der Autoren des Modells sowie FP8- oder 4-Bit-Versionen der Autoren oder von Drittanbietern. Die Versionen mit geringerer Genauigkeit sind kleiner. In diesem Artikel wird untersucht, wie acht Versionen von drei Qwen-Modellen bei der DGX Station GB300 mit jeweils 1 bis 256 gleichzeitigen Anfragen abgeschnitten haben.
Die Modelle sind Qwen3.8-27B in vier Versionen (BF16, FP8 und NVFP4 von Inferact und von unsloth), Qwen3.6-27B in zwei Versionen (BF16 und NVFP4 von NVIDIA) und Qwen3.6-35B-A3B in zwei Versionen (BF16 und NVFP4 von NVIDIA). Ebenso viele Messungen sind auch in dem Artikel dieser Reihe enthalten, der alle 15 kleinen und mittelgroßen Modelle auf der Station behandelt; hier werden sie miteinander verglichen.
Wie ich das Messen durchgeführt habe
Ich habe verwendet aiperf_tool, ein kleiner Rahmen, den ich um den Benchmark-Client AIPerf von NVIDIA und den vLLM-Inferenzserver gebaut habe. Jedes Modell läuft in einem eigenen vLLM-Container, und der Benchmark sendet Anfragen mit der gleichen Größe: eine Anforderung mit 1.024 Zeichen (ein wenig mehr, wenn sie in die Chat-Vorlage jedes Modells eingebettet wird) und genau 512 Ausgabetoken. Das Modell darf nicht vorzeitig stoppen, also erledigt jede Anfrage dieselbe Arbeit. Jedes Ladevorgangsspektrum dauert fünf Minuten und wurde zweimal gemessen.
Die Belastung wird als gleichzeitige Anfragen angegeben. Jede gleichzeitige Anfrage ist ein Slot, der seine nächste Anfrage sendet, sobald die vorherige Antwort abgeschlossen ist, ohne die Pausen, die eine Person für das Lesen und Tippen benötigt.
Der Benchmark misst die Geschwindigkeit: die Gesamtzahl der Token pro Sekunde, wie schnell die einzelnen Antworten fließen und die Zeit bis zum ersten Token. Er misst nicht die Qualität der Antworten, daher sagt er nichts darüber aus, ob eine Version mit geringerer Präzision genauso gut antwortet wie die Originalversion. Er wurde ohne spekulativen Dekodierung ausgeführt.
| System | NVIDIA DGX Station GB300, 288 GB HBM3e |
| Modelle | 8 Versionen der 3 Qwen-Modelle |
| Zusammengesetzte Anfragen | 1, 4, 16, 32, 64, 128; 256 für die fünf Versionen von FP8 und NVFP4 |
| Laufkilometer pro Lastniveau | 2 |
| Inferenzserver | vLLM v0.29.0, 40 % der GPU-Speicherkapazität, FP8 KV-Cache |
| Arbeitsaufwand | 1.024 Eingabesteuerelemente / 512 Ausgabesteuerelemente, 5 Minuten pro Level |
| Daten | aiperf_dgx_station_260918 |
Die Präzisionen
Die Gewichtungen eines Modells werden als Zahlen gespeichert, und die Genauigkeit ist die Anzahl der Bits, die jede Zahl verwendet. BF16 verwendet 16 Bits pro Gewichtung, FP8 8 Bits, und NVFP4, das 4-Bit-Format von NVIDIA für die Blackwell GPUs, verwendet 4 Bits plus eine kleine Menge Skalierungsdaten. Je weniger Bits, desto kleiner das Modell und desto weniger Daten müssen aus dem Speicher für jeden generierten Token gelesen werden. Wie ein Modell auf eine niedrigere Präzision umgestellt wird, variiert je nach Publisher.
Alle acht Versionen verwendeten dieselbe vLLM-Version und denselben Speicherbegrenzer von 40 % der GPU-Speicher. Ein kleineres Modell lässt mehr Platz für den KV-Cache, der den Kontext jeder aktiven Anforderung speichert. Eine Ausnahme: Die NVFP4-Version von Qwen3.6-35B-A3B von NVIDIA läuft auch mit zwei zusätzlichen vLLM-Einstellungen für die Aufmerksamkeit und den Expertenrechner (– attention-backend flashinfer, –moe-backend marlin); daher isoliert der Vergleich mit der Version BF16 das Format nicht.
So lesen Sie die Diagramme
Die in diesem Artikel dargestellten Diagramme sind Pareto-Kurven, die AIPerf für jedes Modell generiert. Hier ist Inferact/Qwen3.8-27B-NVFP4 zu sehen:

Die vertikale Achse ist der Gesamtoutput in Tokens pro Sekunde. Die Station verfügt über eine einzige GPU, daher lautet “per GPU” einfach die Gesamtzahl. Die horizontale Achse gibt an, wie schnell eine Antwortströme anfallen, in Tokens pro Sekunde pro Anfrage (AIPerf bezeichnet dies als “per User”). Jeder Punkt entspricht einer Laststufe, und die Zahl neben ihm ist die Konkurrentenzahl.
Bei einer gleichzeitigen Anforderung auf der äußersten rechten Spalte streamt diese Version eine Antwort mit einer Geschwindigkeit von etwa 153 Token pro Sekunde. Wenn man nach oben und nach links scrollt, steigt die Konzentration der Anforderungen: Bei 256 gleichzeitigen Anfragen fließen jede Antwort mit einer Geschwindigkeit von etwa 31 Token pro Sekunde, während das System insgesamt etwa 7.400 Ergebnisse erzeugt. Die Linie verknüpft die Laststufen, die auf beiden Achsen gleichzeitig nicht übertroffen werden können; ein Punkt außerhalb der Linie weist sowohl eine geringere Gesamtlaufzeit als auch langsamerere Antworten auf als eine andere Laststufe. Die Skalierungsachsen passen sich an jedes Modell an, daher sollten Sie sie überprüfen, bevor Sie zwei Diagramme miteinander vergleichen.
Alle acht Versionen
| Modell | Präzision | Größe | 1 Anfrage: tok/s, TTFT | 16 simultane Anfragen: tok/s pro Anfrage, insgesamt, TTFT | 32 simultane: tok/s pro Anfrage, insgesamt, TTFT | Gesamtsumme (at) |
|---|---|---|---|---|---|---|
| Qwen/Qwen3.8-27B | BF16 | 52 GB | 89,9, 0,07 s | 77,5, 1.135, 0,62 s | 69,7, 1.957, 1,03 s | 4,257 (128) |
| Qwen/Qwen3.8-27B-FP8 | FP8 | 29 GB | 111,5, 0,09 s | 80,3, 940, 2,33 s | 72,5, 1.414, 4,43 s | 2,237 (256) |
| Inferact/Qwen3.8-27B-NVFP4 | NVFP4 | 25 GB | 153,2, 0,12 s | 122,5, 1.783, 0,42 s | 107,0, 3.005, 0,67 s | 7,384 (256) |
| unsloth/Qwen3.8-27B-NVFP4 | NVFP4 | 22 GB | 150,0, 0,10 s | 121,4, 1.768, 0,42 s | 106,0, 2.973, 0,68 s | 7,123 (256) |
| Qwen/Qwen3.6-27B | BF16 | 52 GB | 89,9, 0,06 s | 77,6, 1.137, 0,61 s | 70,0, 1.955, 1,07 s | 4,236 (128) |
| nvidia/Qwen3.6-27B-NVFP4 | NVFP4 | 20 GB | 132,4, 0,18 s | 107,2, 1.263, 1,72 s | 84,5, 1.787, 3,10 s | 2,461 (128) |
| Qwen/Qwen3.6-35B-A3B | BF16 | 67 GB | 312,4, 0,11 s | 165,4, 2.459, 0,24 s | 129,3, 3.742, 0,42 s | 8,491 (128) |
| nvidia/Qwen3.6-35B-A3B-NVFP4 | NVFP4 | 22 GB | 276,7, 0,13 s | 179,4, 2.549, 0,36 s | 145,5, 4.021, 0,56 s | 7,828 (128) |
Die Tokens pro Sekunde pro Anforderung geben an, wie schnell eine Antwortströme abgesetzt werden; die Gesamtzahl ist die Anzahl der ausgegebenen Tokens aller innerhalb des Messbereichs abgeschlossenen Anfragen geteilt durch die Länge des Messbereichs. TTFT ist die mittlere Zeit bis zum ersten Token. Size ist die Größe des Repositories des Modells bei Hugging Face. Die BF16-Versionen wurden mit bis zu 128 parallelen Anfragen getestet, die anderen mit bis zu 256.
Qwen3.8-27B
Qwen3.8-27B ist ein dichtes Modell: Jeder generierte Token durchläuft alle 27 Milliarden Parameter. Mit einer Anfrage pro Mal war jede Version mit niedrigerer Präzision schneller als die ursprüngliche BF16-Version: Die FP8-Version streamte etwa 112 Tokens pro Sekunde, die beiden NVFP4-Versionen etwa 150 bis 153, im Vergleich zu 90 für BF16.

Qwen/Qwen3.8-27B auf der DGX Station.
Bei Belastung trennten sich die vier Versionen voneinander. Die beiden NVFP4-Versionen von Inferact und unsloth verhielten sich nahezu identisch, mit insgesamt etwa 3.000 Tokens pro Sekunde bei 32 gleichzeitig stattgehenden Anfragen und 6.000 bis 6.200 bei 128, 42 bis 45 % mehr als die BF16-Version auf diesem Niveau (4.257, der höchsten Ebene, auf der sie getestet wurde). Bei 256 erreichten sie 7.100 bis 7.400. Die FP8-Version produzierte insgesamt weniger als die BF16-Version bei 16 gleichzeitig stattgehenden Anfragen und erreichte bei 256 einen Spitzenwert von 2.237 Tokens pro Sekunde.

unsloth/Qwen3.8-27B-NVFP4 auf der DGX Station. Die Grafik für die Inferact-Version ist das obige Beispiel.

Qwen/Qwen3.8-27B-FP8 auf der DGX Station.
Der Unterschied zeigt sich am deutlichsten in der Zeit bis zum ersten Token. Bei der FP8-Version stieg sie auf etwa 2,3 Sekunden bei 16 gleichzeitigen Anfragen und auf 4,4 Sekunden bei 32, während die BF16-Version bei 0,6 und 1,0 Sekunden und die NVFP4-Versionen bei 0,4 und 0,7 blieb. Das Diagramm von AIPerf zur Durchsatzleistung der Anfragen im Verhältnis zur Zeit bis zum ersten Token zeigt, wie sich die Leistung über die verschiedenen Laststufen entwickelt:
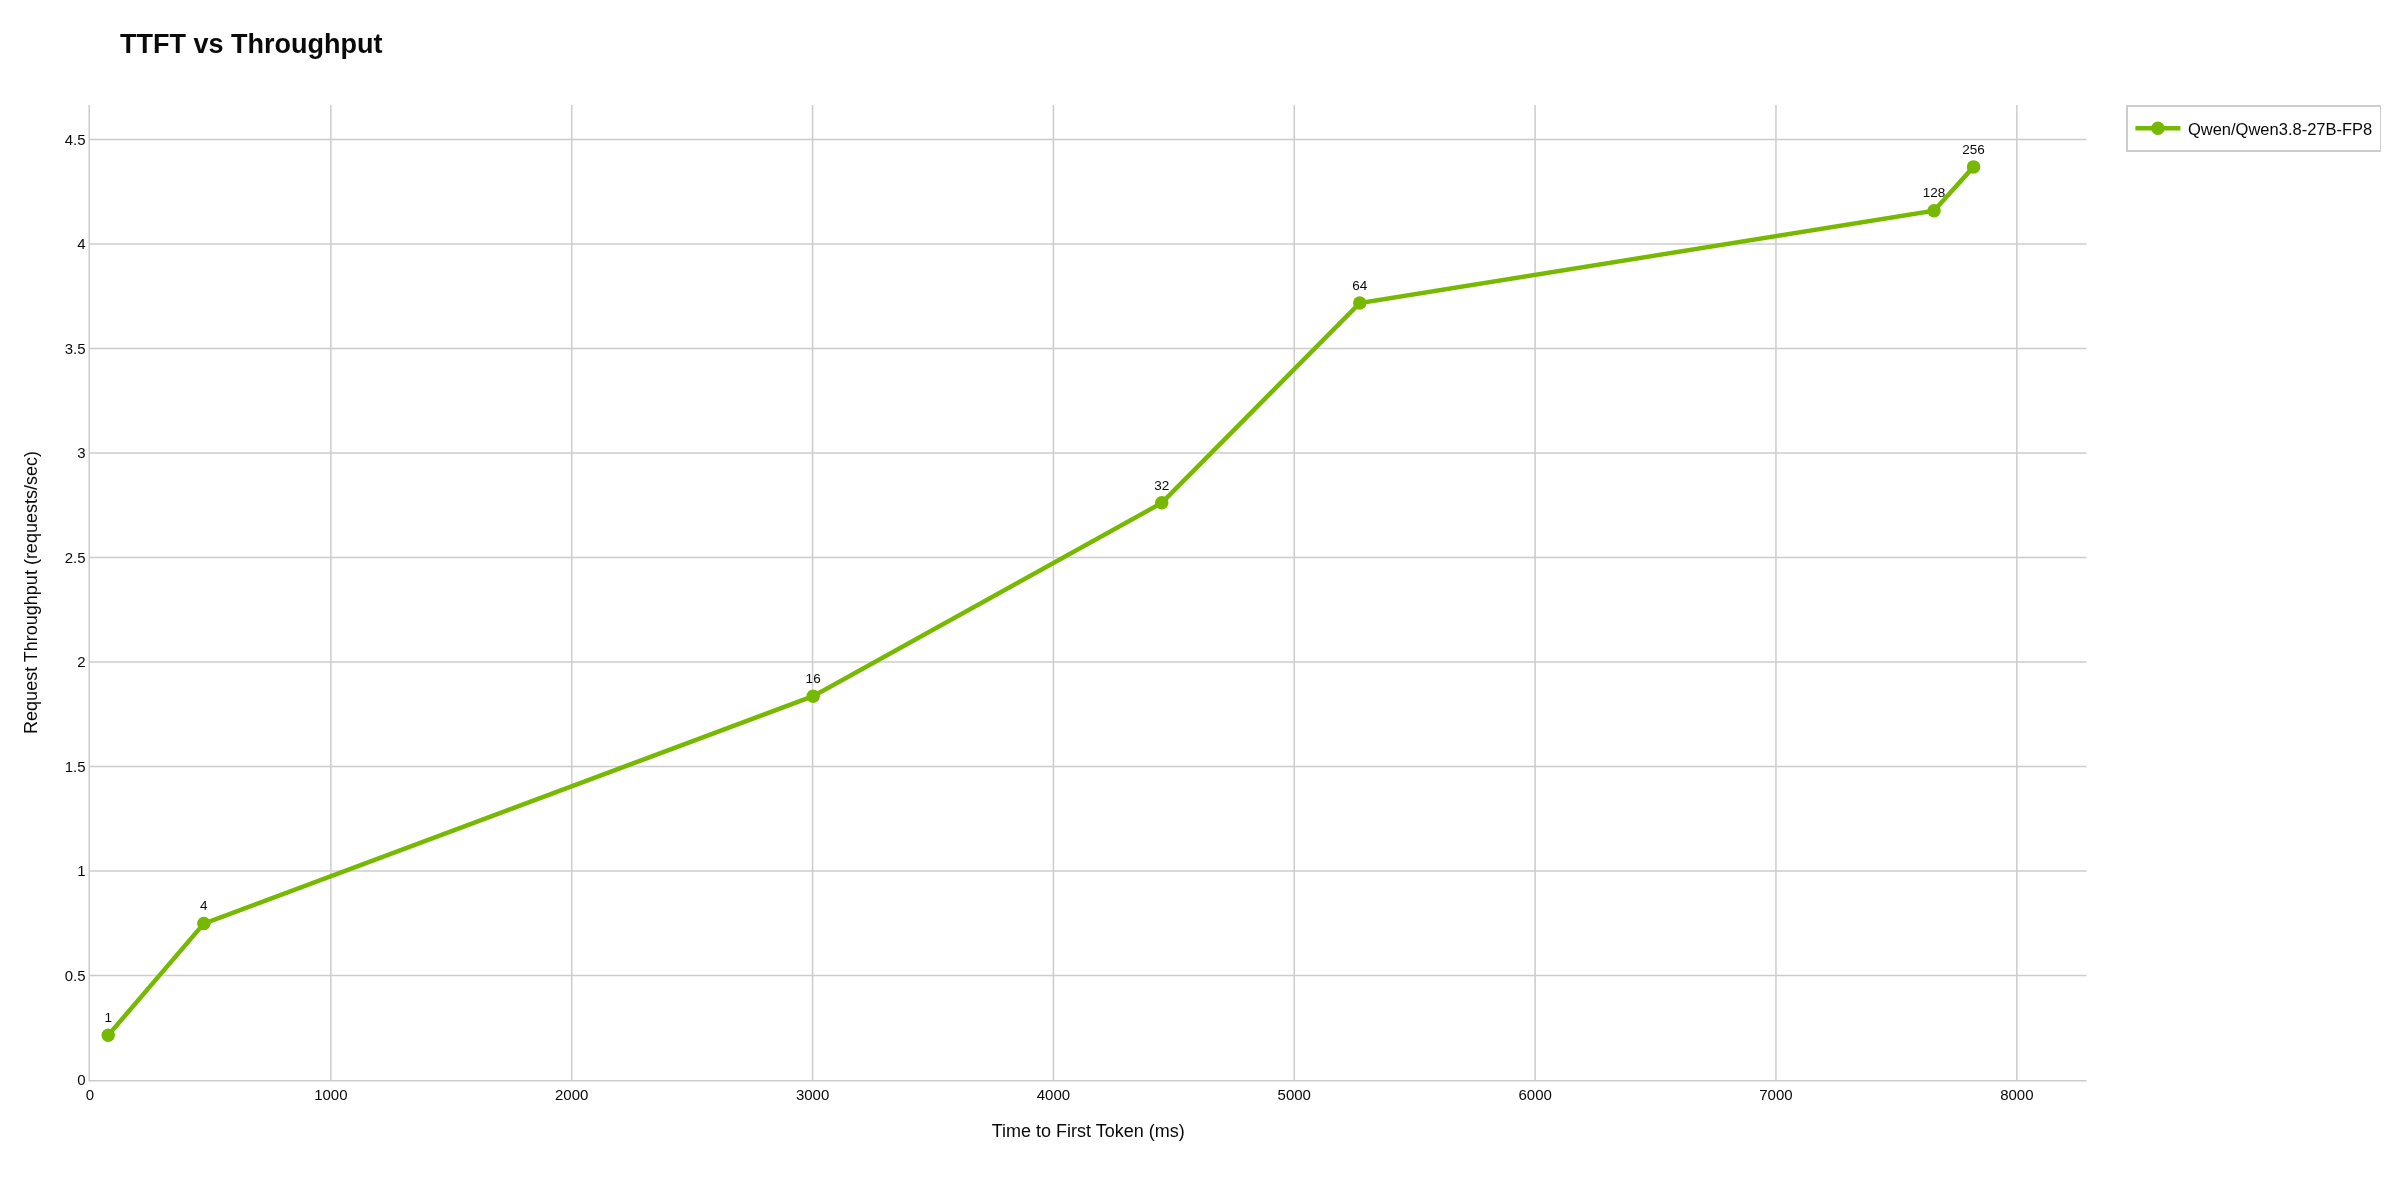
Qwen/Qwen3.8-27B-FP8 auf der DGX Station: abgeschlossene Anfragen pro Sekunde im Vergleich zur durchschnittlichen Zeit bis zur ersten Token-Erfassung, jeweils ein Punkt pro Lastebene.
Qwen3.6-27B
Qwen3.6-27B ist auch ein dichtes Modell mit 27 Milliarden Parametern. Die BF16-Versionen von Qwen3.6-27B und Qwen3.8-27B lieferten bei allen Laststufen nahezu identische Durchsatzraten.

Qwen/Qwen3.6-27B auf der DGX Station.
Die NVFP4-Version von Qwen3.6-27B von NVIDIA streamte eine einzige Antwort mit einer Geschwindigkeit von etwa 132 Tokens pro Sekunde, schneller als BF16. Bei Belastung stieg die Gesamtübertragungsrate jedoch weniger: 1.787 Tokens pro Sekunde bei 32 gleichzeitig gesendeten Anfragen und ein Höchstwert von 2.461 bei 128, im Vergleich zu 1.955 und 4.236 für BF16. Die Zeit bis zum ersten Token wurde ähnlich wie bei der FP8-Version von Qwen3.8-27B auf etwa 1,7 Sekunden bei 16 und 3,1 Sekunden bei 32 erhöht. Bei 256 sank die Gesamtübertragungsrate auf 1.986.

nvidia/Qwen3.6-27B-NVFP4 auf der DGX Station.
Qwen3.6-35B-A3B
Qwen3.6-35B-A3B ist ein Modell mit Expertenkompetenz, das für jeden Token etwa 3 Milliarden seiner 35 Milliarden Parameter verwendet. Hier hatte die BF16-Version eine höhere Geschwindigkeit bei einer einzigen Anforderung, etwa 312 Tokens pro Sekunde gegenüber 277 bei der NVFP4-Version von NVIDIA, und eine höhere Spitzenleistung von 8.491 gegenüber 7.828 bei 128 gleichzeitig stattgehenden Anfragen. Bei 16, 32 und 64 gleichzeitig stattgefundenen Anfragen lieferte die NVFP4-Version insgesamt etwas mehr (2.549, 4.021 und 5.845 gegenüber 2.459, 3.742 und 5.713). Bei 256 fiel die Gesamtzahl der NVFP4-Anfragen auf 3.738; die BF16-Version wurde nicht auf diesem Niveau getestet.

Qwen/Qwen3.6-35B-A3B auf der DGX Station.

nvidia/Qwen3.6-35B-A3B-NVFP4 auf der DGX Station. Der Punkt für 256 liegt weit außerhalb der Linie.
In allen acht Versionen
Für die beiden dichten Modelle führte jede Version mit geringerer Präzision zu einer schnelleren Streaminggeschwindigkeit als die ursprüngliche Version mit BF16 um 24 bis 70 %. Bei Belastung folgte das Format der Ergebnisse nicht dem Format: Bei 128 gleichzeitig gesendeten Anfragen, bei der höchsten Teststufe für alle Versionen, lieferten die Inferact- und unsloth-NVFP4-Versionen von Qwen3.8-27B eine Gesamtwertung von 42 bis 45 % höher als die BF16-Version, während die NVFP4-Version von Qwen3.6-27B von NVIDIA und die FP8-Version von Qwen3.8-27B jeweils etwa 50 bis 60 % dieser Gesamtleistung lieferten, wobei die Zeit bis zum ersten Token schneller anstieg. Für das Modell mit Experten aus verschiedenen Fachrichtungen lagen die BF16- und NVFP4-Versionen bei allen Stufen bis 128 % übereinander.
Ich habe die Ursachen nicht untersucht. Der KV-Cache war nicht voll: Die eigenen Messwerte von vLLM, die AIPerf zusammen mit den Messwerten erfasst hatte, zeigten, dass er bei der FP8-Version maximal 51 % und bei der NVFP4-Version von Qwen3.6-27B von NVIDIA 33 % volllaufend war bei 128 gleichzeitigen Anfragen, 84 und 66 % bei 256, wobei keine Anfrage vorübergehend ausgelöst wurde.
Grenzen dieses Tests
Jede Lastebene wurde zweimal ausgeführt, jeweils mit einer vLLM-Version (0.29.0) und 40 % GPU-Speicher. Neuere vLLM-Versionen oder neueren Versionen dieser Checkpoints können die Ergebnisse ändern. Die BF16-Versionen wurden nicht mit 256 parallelen Anfragen getestet. Die Benchmark vergleicht die Antwortqualität nicht zwischen den verschiedenen Genauigkeitsstufen. Die Arbeitslast ist synthetisch und die realen Anfragen und Antworten variieren in der Länge.
Daten
Alle Rohdaten, Konfigurationsdateien und Diagramme sind vorhanden. aiperf_dgx_station_260918. Jede Version hat ihren eigenen Ordner unter Artefakte/:
| Modell | Ordner |
|---|---|
| Qwen/Qwen3.8-27B | 20260917_060722_Qwen_Qwen3.8-27B_c1,4,16,32,64,128 |
| Qwen/Qwen3.8-27B-FP8 | 20260917_071251_Qwen_Qwen3.8-27B-FP8_c1,4,16,32,64,128,256 |
| Inferact/Qwen3.8-27B-NVFP4 | 20260916_210841_Inferact_Qwen3.8-27B-NVFP4_c1,4,16,32,64,128,256 |
| unsloth/Qwen3.8-27B-NVFP4 | 20260917_094856_unsloth_Qwen3.8-27B-NVFP4_c1,4,16,32,64,128,256 |
| Qwen/Qwen3.6-27B | 20260917_035547_Qwen_Qwen3.6-27B_c1,4,16,32,64,128 |
| nvidia/Qwen3.6-27B-NVFP4 | 20260917_012119_nvidia_Qwen3.6-27B-NVFP4_c1,4,16,32,64,128,256 |
| Qwen/Qwen3.6-35B-A3B | 20260917_050205_Qwen_Qwen3.6-35B-A3B_c1,4,16,32,64,128 |
| nvidia/Qwen3.6-35B-A3B-NVFP4 | 20260917_023947_nvidia_Qwen3.6-35B-A3B-NVFP4_c1,4,16,32,64,128,256 |
Die genauen vLLM-Einstellungen für jede Version sind in conf/model_compose_overrides/.
Wenn Sie bei der Auswahl zwischen Präzision und Checkpoints für ein Modell auf der DGX Station entscheiden müssen, würden wir uns freuen, Ihre Anforderungen zu hören. Wir können die von Ihnen betrachteten Versionen anhand Ihrer eigenen Anforderungsprofile und Antwortlängen vergleichen und Ihnen helfen, zu beurteilen, was die Ergebnisse für Ihren Anwendungsfall bedeuten.
 Deutsch (Sie)
 English