DGX Station GB300: Wie vLLM-Einstellungen die Ergebnisse von fünf großen Modellen verändert haben
Ein Benchmark-Ergebnis beschreibt ein Modell, das mit einer bestimmten Konfiguration ausgeführt wird, nicht das Modell selbst. Ich habe dieselben fünf große Mischung-von-Experten-Modelle am 17. und 18. September zweimal auf der DGX Station GB300 ausgeführt, wobei zwischen den Durchläufen einige vLLM-Einstellungen geändert wurden. In diesem Artikel werden die beiden Durchläufe miteinander verglichen: in welchen Bereichen blieben die Ergebnisse gleich, in welchen sich die Änderungen änderten und wie groß die Änderungen im Vergleich zur normalen Variation zwischen wiederholten Messungen waren.
Wie ich das Messen durchgeführt habe
Ich habe verwendet aiperf_tool, ein kleiner Harness, den ich um den Benchmark-Client AIPerf von NVIDIA und den vLLM-Inferenzserver herum aufgebaut habe. Jedes Modell läuft in einem eigenen vLLM-Container, und der Benchmark sendet Anfragen mit der gleichen Größe: eine 1.024-Token-Anforderung (ein wenig mehr, wenn sie in die Chat-Vorlage jedes Modells eingebettet wird) und genau 512 Ausgabetoken. Das Modell darf nicht vorzeitig beendet werden, daher erledigt jede Anfrage dieselbe Arbeit. Jedes Ladevorgangsspektrum dauert fünf Minuten und wurde in jeder Ausführung zweimal gemessen.
Die Belastung wird als gleichzeitige Anfragen angegeben. Jede gleichzeitige Anfrage ist ein Slot, der seine nächste Anfrage sendet, sobald die vorherige Antwort abgeschlossen ist, ohne die Pausen, die eine Person für das Lesen und Tippen benötigt.
Der Benchmark misst die Geschwindigkeit: die Gesamtzahl der Token pro Sekunde, wie schnell die einzelnen Antwortströme fließen und die Zeit bis zum ersten Token. Er misst nicht die Antwortqualität und wurde ohne spekulativen Dekodierung durchgeführt.
| Lauf 1 | Lauf 2 | |
|---|---|---|
| System | NVIDIA DGX Station GB300 | gleichermaßen |
| Modelle | 5 große MoE-Modelle | gleichermaßen |
| Zusammengesetzte Anfragen | 1, 4, 16, 32 (MiniMax-M2.7: auch 64) | 1, 4, 16, 32, 64, 128 |
| Repetitionsraten je Laststufe | 2 | 2 |
Anfragen, die parallel bearbeitet werden (--max-num-seqs) | bis zu 64 | bis zu 128 |
| Daten | aiperf_dgx_station_260918 | aiperf_dgx_station_260919 |
Was sich zwischen den Läufen verändert hat
| Modell | Lauf 1 | Lauf 2 |
|---|---|---|
| MiniMaxAI/MiniMax-M2.7 | 64 parallele Anfragen, 25 GB CPU-Speicher | 128 parallele Anfragen, ansonsten unverändert |
| RedHatAI/GLM-5.3-Flash-NVFP4 | 64 parallele Anfragen, keine CPU-Ablastung | 128 parallele Anfragen, ansonsten unverändert |
| nvidia/NVIDIA-Nemotron-3-Ultra-550B-A55B-NVFP4 | 64 parallele Anfragen, 150 GB Expertengewicht in der CPU-Speicher | 128 parallele Anfragen, ansonsten unverändert |
| nvidia/DeepSeek-V4-Flash-nvfp4-DSpark | 64 parallele Anfragen, keine CPU-Ablastung | 128 parallele Anfragen, 15 GB Expertengewicht in der CPU-Speicher, Tool-Call-Parsing aktiviert |
| zai-org/GLM-5.3-Flash (BF16) | 64 parallele Anfragen, 110 GB CPU-Speicher | 128 parallele Anfragen, 130 GB CPU-Speicher |
Zwei dieser Einstellungen erfordern eine kurze Erklärung.
--max-num-seqs ist die maximale Anzahl an Anfragen, die vLLM gleichzeitig verarbeitet; weitere Anfragen warten in einer Warteschlange. vLLM reserviert bei der Inbetriebnahme Arbeitsspeicher für diese maximale Zahl, sodass ein höherer Wert weniger Speicher für andere Zwecke übrig lässt. In der ersten Ausführung habe ich die Größe auf 64 gesetzt – die höchste Belastungseinstellung, die für diese Modelle geplant ist. In der zweiten Ausführung habe ich sie auf 128 erhöht, um mit der neuen Höchstbelastungseinstellung übereinzustimmen.
--cpu-offload-gb Bewirbt eine bestimmte Menge an Gewichtungen eines Modells aus der GPU-Speicherung in die Speicherung der Grace-CPU. vLLM bewegt die festgelegte Menge unabhängig davon, wie viel Speicherplatz in der GPU frei ist, und die bewegten Gewichtungen überqueren die Verbindung zwischen CPU und GPU für jeden generierten Token. –cpu-offload-params Experten, Nur Expertengewichte werden verschoben; jedes Token verwendet dabei nur wenige davon.
Die genauen Konfigurationsdateien für beide Ausführungen befinden sich in jedem Repository. conf/ Ordner.
Ergebnisse bei der gleichen Konzentration
Beide Laufwerke teilen die Ladelevel 1, 4, 16 und 32 (MiniMax-M2.7 auch 64). Gesamte Durchsatzleistung in Tokens pro Sekunde, Lauf 1 → Lauf 2:
| Modell | 1 | 4 | 16 | 32 | 64 |
|---|---|---|---|---|---|
| MiniMaxAI/MiniMax-M2.7 | 105 → 107 | 221 → 224 | 392 → 400 | 542 → 554 | 814 → 821 |
| RedHatAI/GLM-5.3-Flash-NVFP4 | 132 → 132 | 408 → 410 | 1,017 → 1,019 | 1,507 → 1,506 | |
| nvidia/NVIDIA-Nemotron-3-Ultra-550B-A55B-NVFP4 | 30 → 30 | 50 → 50 | 74 → 74 | 99 → 99 | |
| nvidia/DeepSeek-V4-Flash-nvfp4-DSpark | 159 → 138 | 485 → 338 | 1,064 → 646 | 1,708 → 714 | |
| zai-org/GLM-5.3-Flash (BF16) | 30 → 27 | 69 → 61 | 126 → 99 | 149 → 149 |
Bei zai-org/GLM-5.3-Flash sind die Gesamtzahlen bei 16 (Ausführung 2) und 32 (Ausführung 1) durch das Messfenster von AIPerf beeinträchtigt; je nach Anforderung war die Ausführung 2 auf allen Ebenen langsamer.
Bei den drei Modellen, bei denen nur die Anzahl der parallelen Anfragen variierte, entsprach das Ergebnis bei gleicher Auslastung etwa 2 %. Bei diesen Lasten war die höhere Grenze nicht von Bedeutung, was mit der Annahme übereinstimmt, dass die Grenze erst über 64 gilt.
zai-org/GLM-5.3-Flash erreichte mit 20 GB mehr seiner Gewichtungen in der CPU-Speicher im zweiten Lauf 10 bis 12 % weniger Tokens pro Sekunde für jeden Request; bei allen Ladevorgängen (1 bis 32) waren diese Werte übereinstimmend. Die beiden Wiederholungen innerhalb eines Laufes unterschieden sich maximal um 0,05 Tokens pro Sekunde pro Request, sodass der Unterschied zwischen den Laufen weit über die normale Variabilität hinausgeht.
nvidia/DeepSeek-V4-Flash-nvfp4-DSpark erzielte im zweiten Lauf insgesamt 13 bis 58 % weniger Ergebnisse. Dieses Modell variierte zudem zwischen den Wiederholungen häufiger als jedes andere im Test: Bei 32 gleichzeitig laufenden Anfragen lieferten die beiden Wiederholungen in Lauf 1 jeweils 1.398 und 2.019 Tokens pro Sekunde, in Lauf 2 hingegen 600 und 828. Trotzdem lag die höhere Wiederholung in Lauf 2 bei jeder gemeinsamen Belastungsebene unter der niedrigeren Wiederholung in Lauf 1. In Lauf 2 verfügte dieses Modell über 15 GB Expertengewicht in der CPU-Speicher und die Aktivierung der Tool-Call-Parsing-Funktion; die Messungen trennen die beiden Änderungen nicht voneinander.
Ergebnisse bei den neuen Laststufen
Run 2 verlängerte den Test auf 128 gleichzeitige Anfragen, und vier der fünf Modelle erreichten dort ihren höchsten Gesamtwert an Durchsatz:
| Modell | Höchstwert in der ersten Runde (at) | Höchstwert in Runde 2 (at) |
|---|---|---|
| RedHatAI/GLM-5.3-Flash-NVFP4 | 1,507 (32) | 3,045 (128) |
| nvidia/DeepSeek-V4-Flash-nvfp4-DSpark | 1,708 (32) | 2,088 (128) |
| MiniMaxAI/MiniMax-M2.7 | 814 (64) | 1,263 (128) |
| nvidia/NVIDIA-Nemotron-3-Ultra-550B-A55B-NVFP4 | 99 (32) | 192 (128) |
| zai-org/GLM-5.3-Flash (BF16) | 149 (32) | 214 (64) |
Bei zai-org/GLM-5.3-Flash zeigt der eigene Token-Counter von vLLM 307 Token pro Sekunde bei 128, gegenüber den 212 bei 64; bei 128 dauerte eine einzelne Anforderung etwa drei halbe Minuten, und AIPerf zählt nur Anfragen, die innerhalb des Messbereichs abgeschlossen werden.
Diese Peaks sind nicht direkt vergleichbar, da Lauf 1 mit 32 (MiniMax: 64) gleichzeitigen Anfragen endete. Die höheren Peaks in Lauf 2 resultieren aus den höheren Lasten. GLM-5.3-Flash-NVFP4 zeigt dies am deutlichsten: Bei 32 gleichzeitigen Anfragen lieferten beide Lauf 1507 Tokens pro Sekunde, bei 128 in Lauf 2 sogar doppelt so viele.
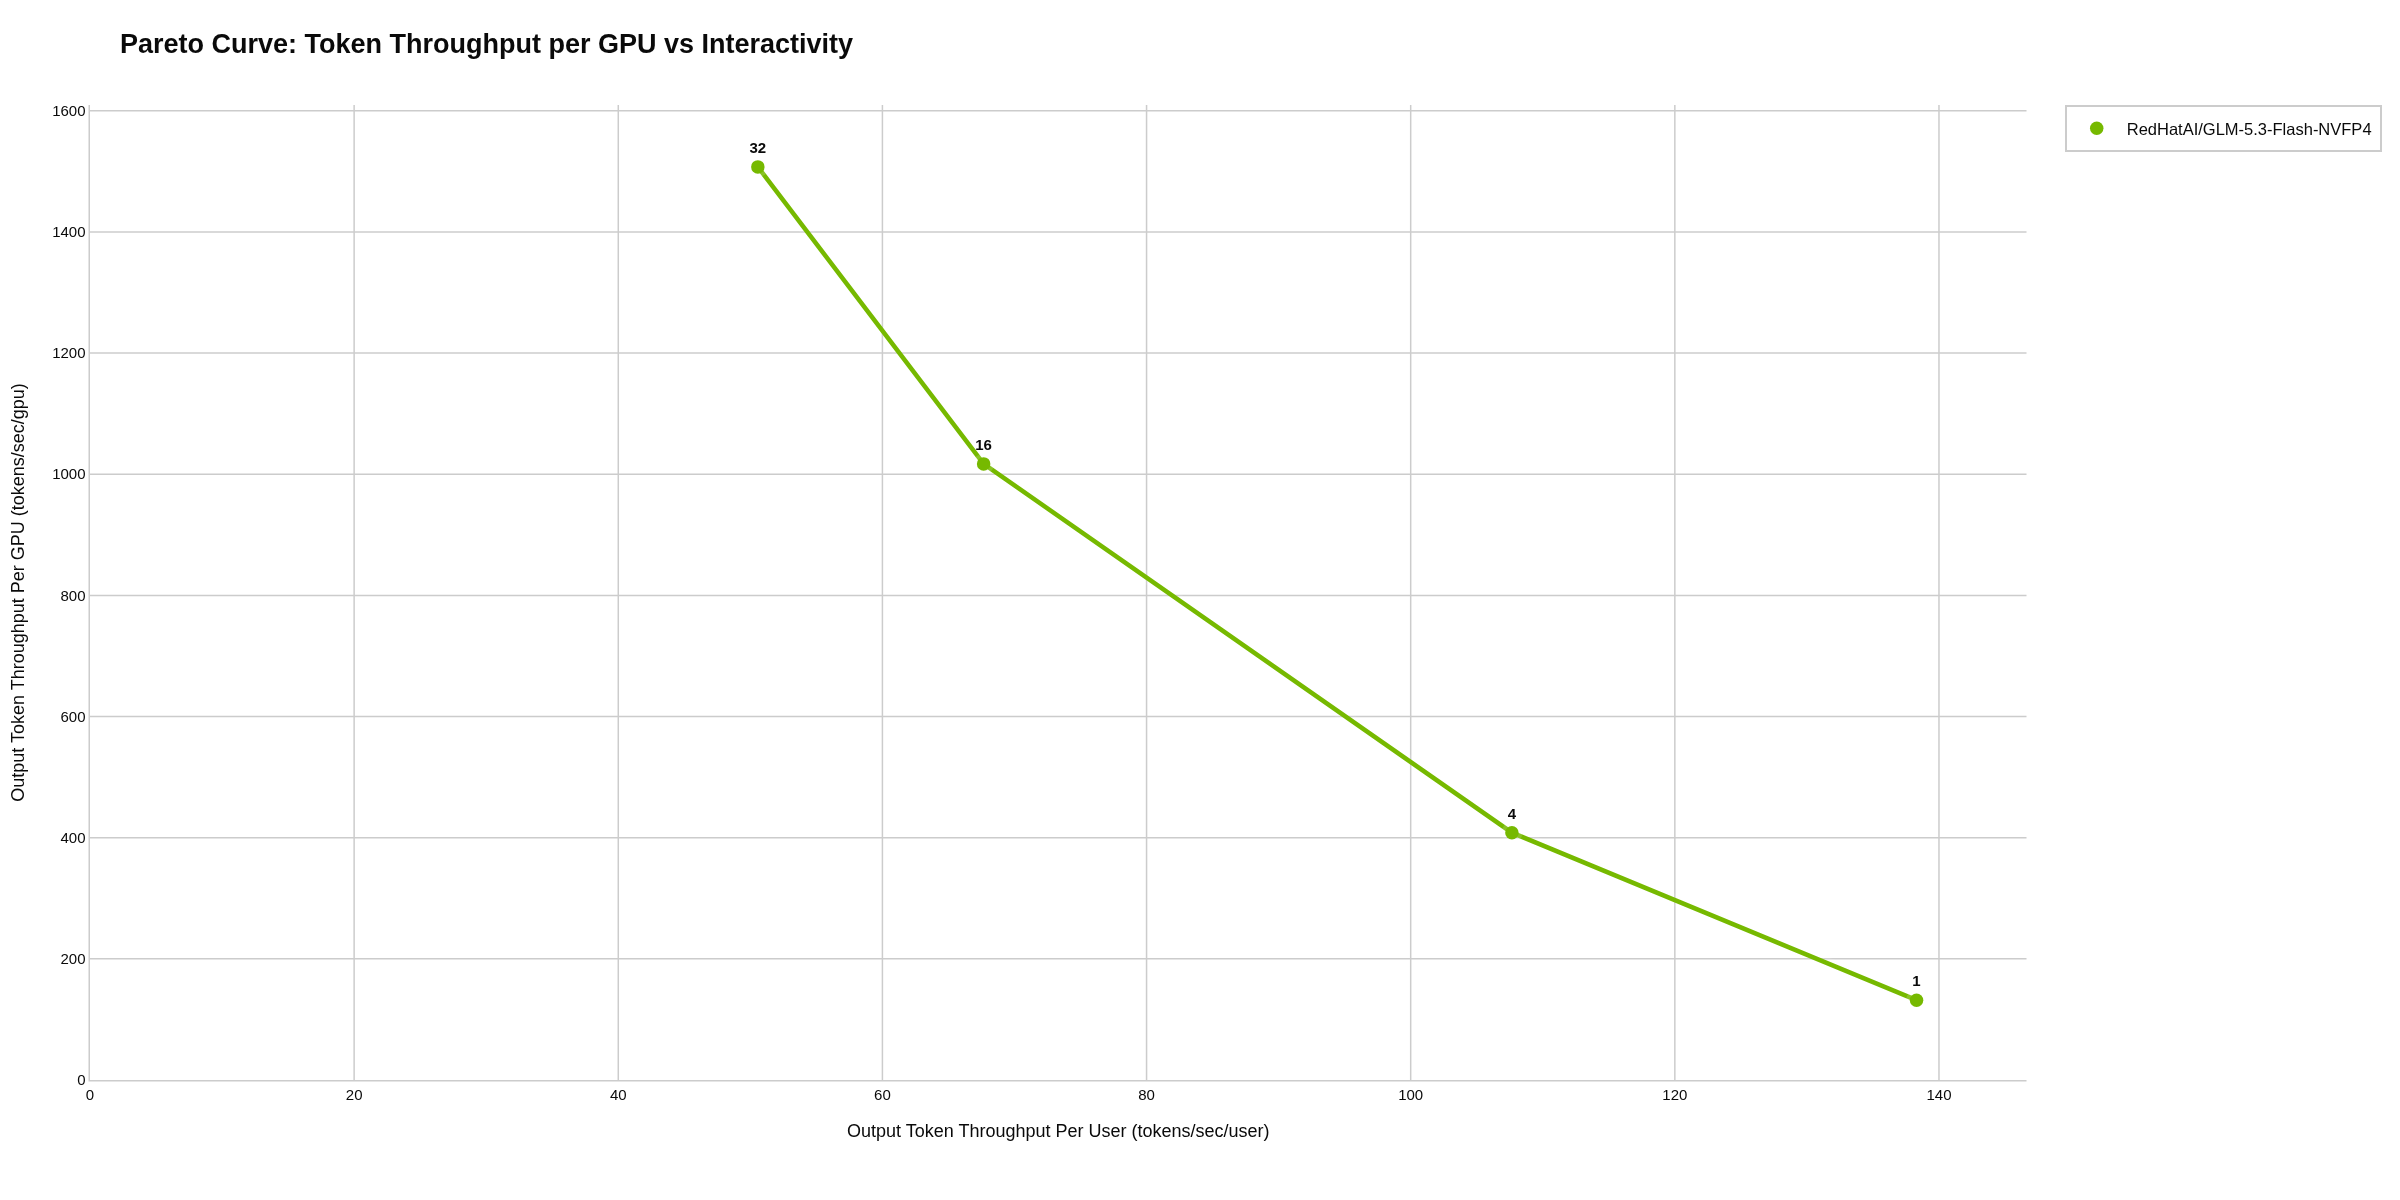
RedHatAI/GLM-5.3-Flash-NVFP4, Laufzeit 1: bis zu 32 gleichzeitig aktive Anfragen.
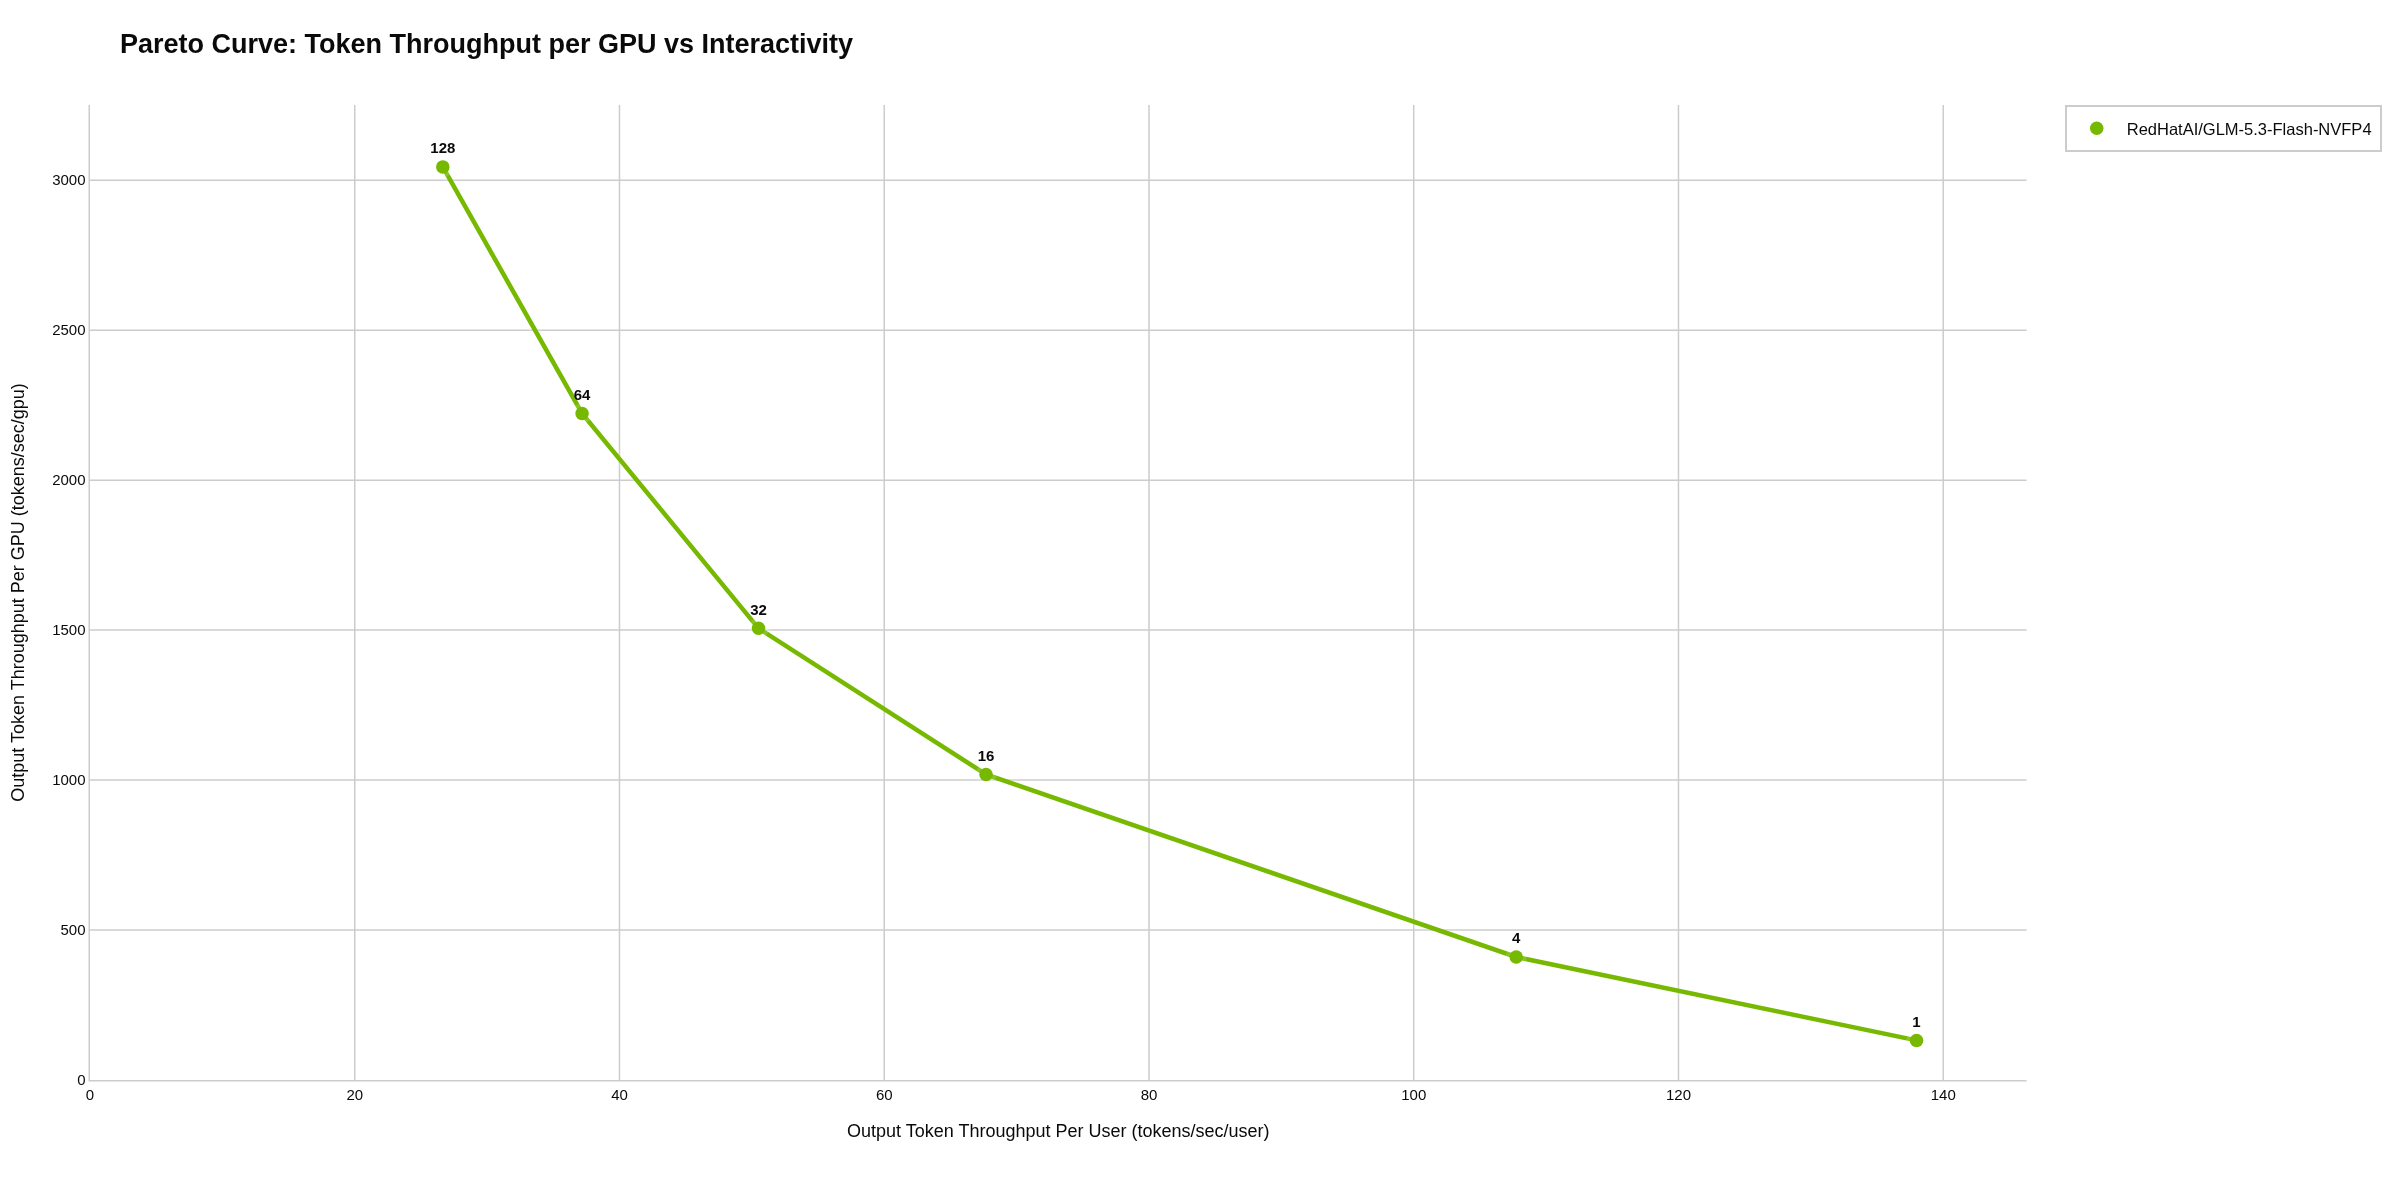
RedHatAI/GLM-5.3-Flash-NVFP4, Laufzeit 2: bis zu 128 gleichzeitig anfragende Prozesse. Jede Grafik ist eine Pareto-Kurve: Die vertikale Achse zeigt die Gesamtzahl der Tokens pro Sekunde an, die horizontale Achse die Geschwindigkeit der Antwortströme und jedes Punkt repräsentiert eine Ladeebene. Die Skalierungsgrade der beiden Diagramme unterscheiden sich.
Bei den anderen vier Modellen wird zuerst der Run-1-Chart angezeigt, dann der Run-2-Chart.
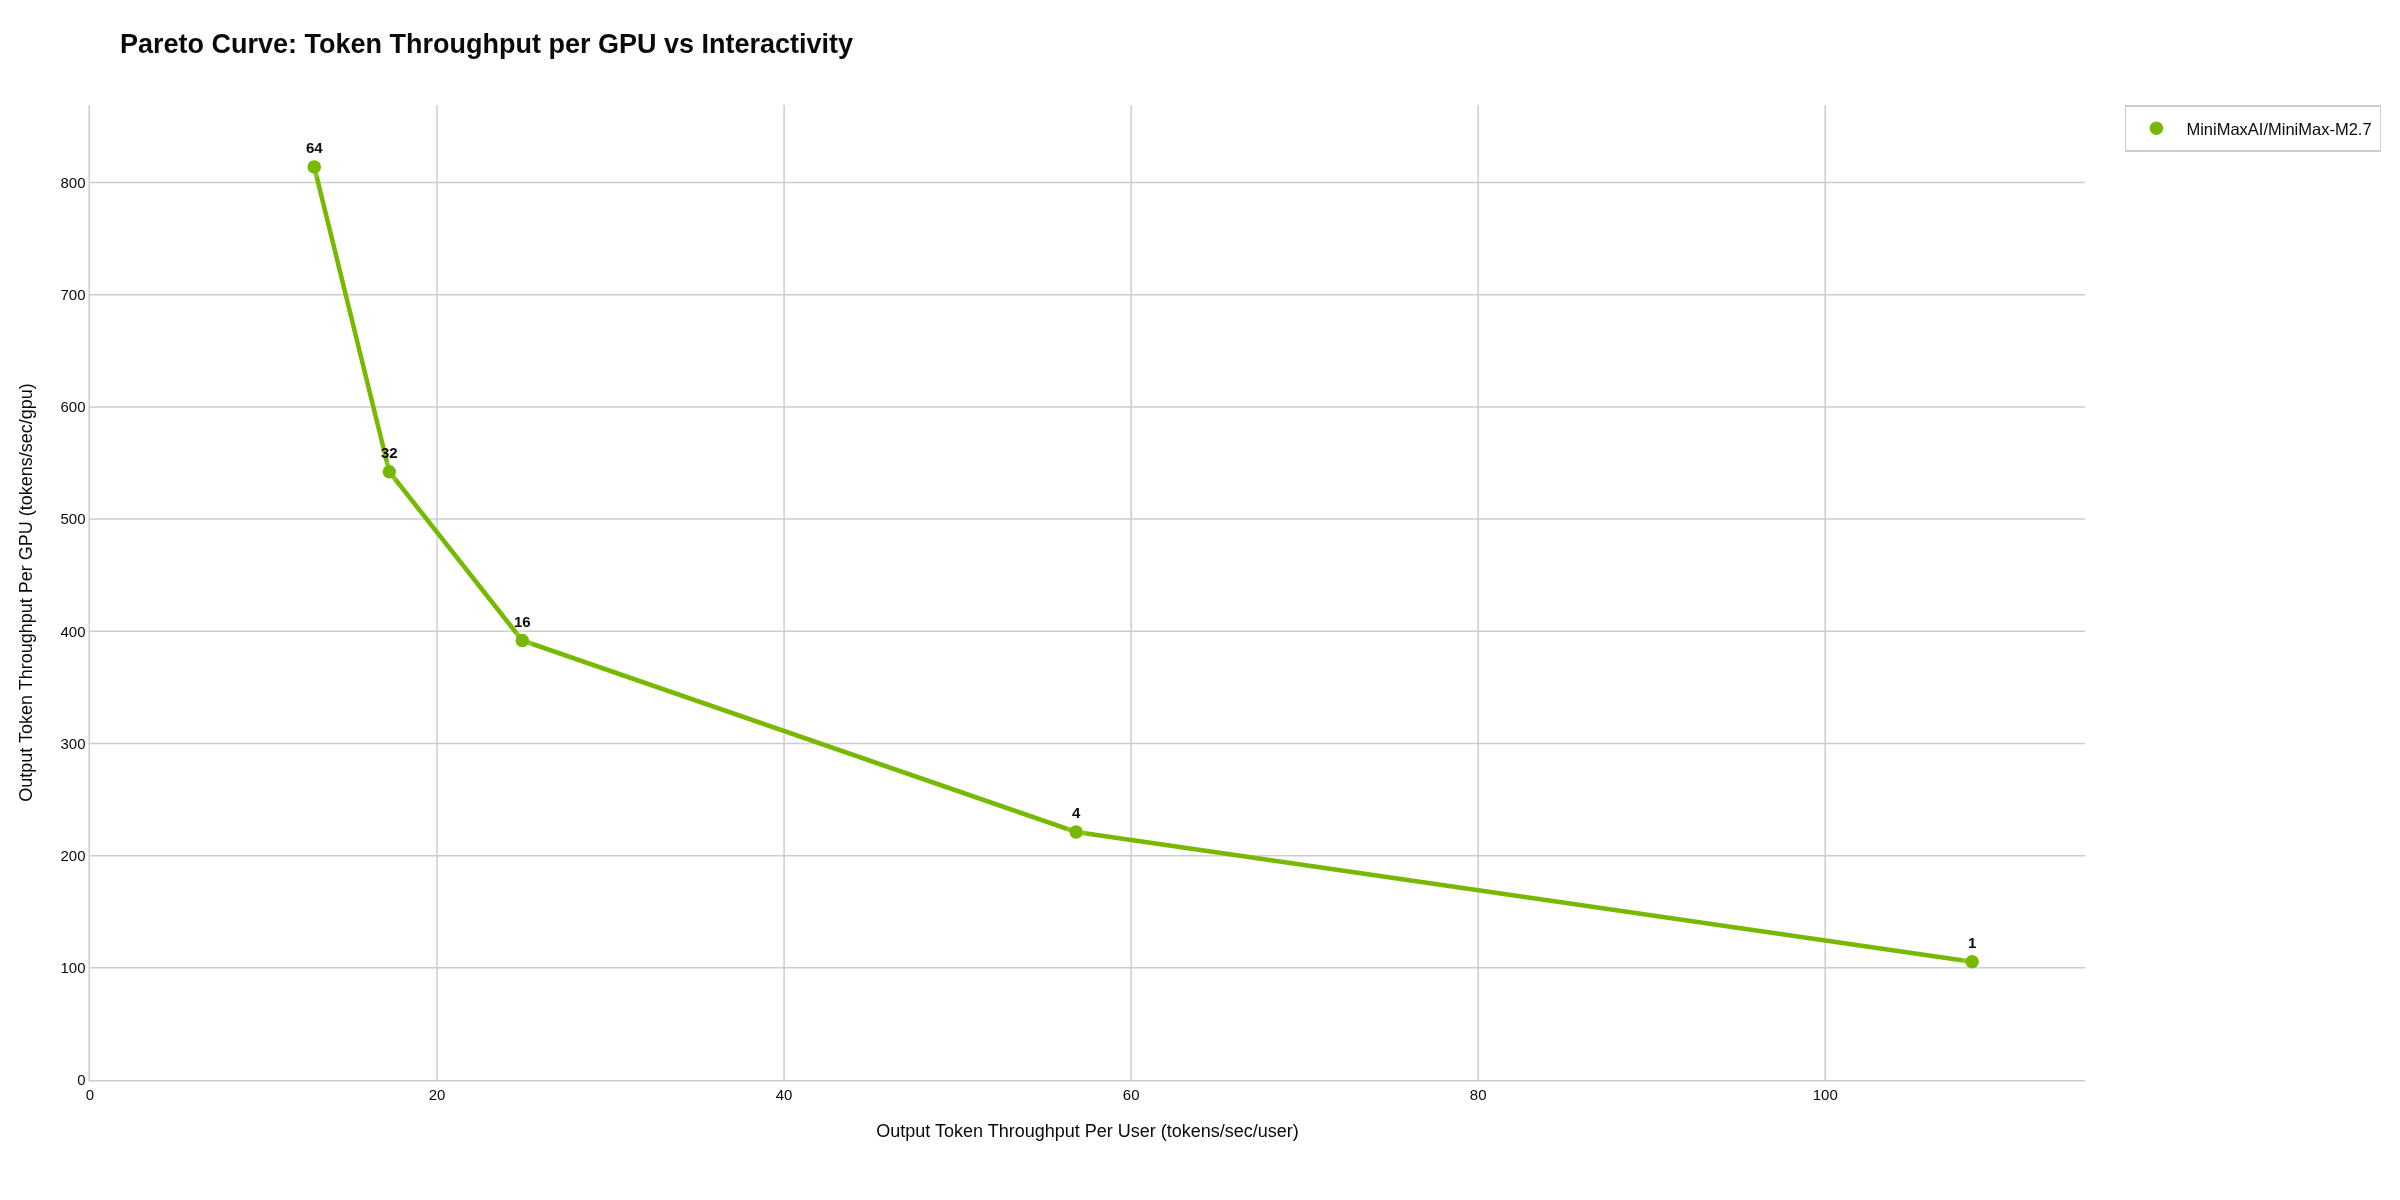
MiniMaxAI/MiniMax-M2.7, Laufzeit 1: bis zu 64 gleichzeitig anfragende Prozesse.
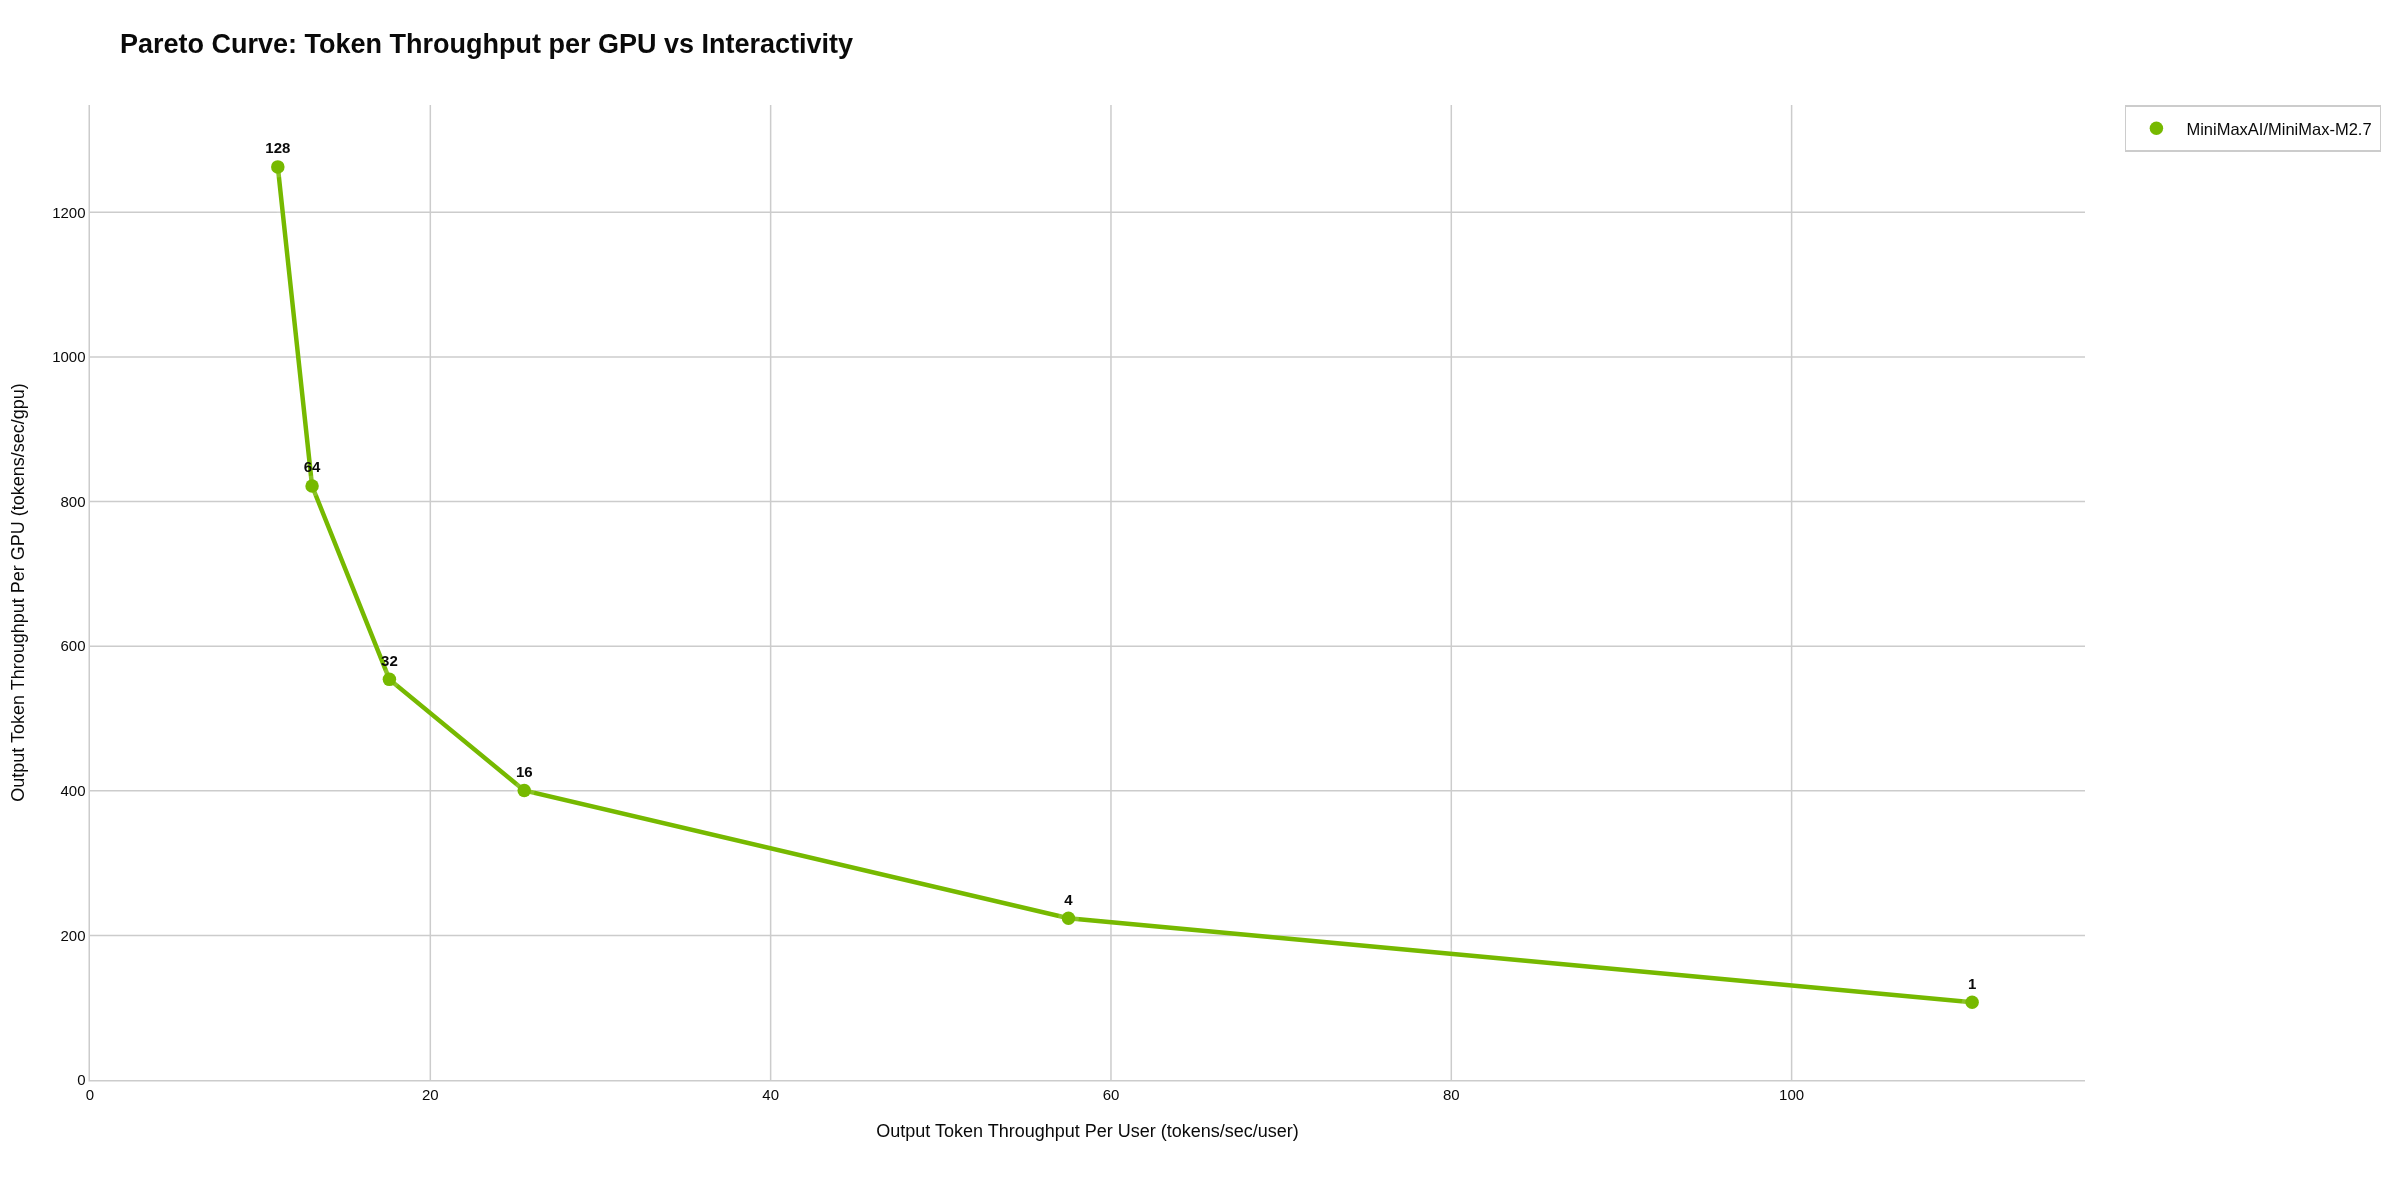
MiniMaxAI/MiniMax-M2.7, Version 2: bis zu 128 gleichzeitig anfragende Prozesse.
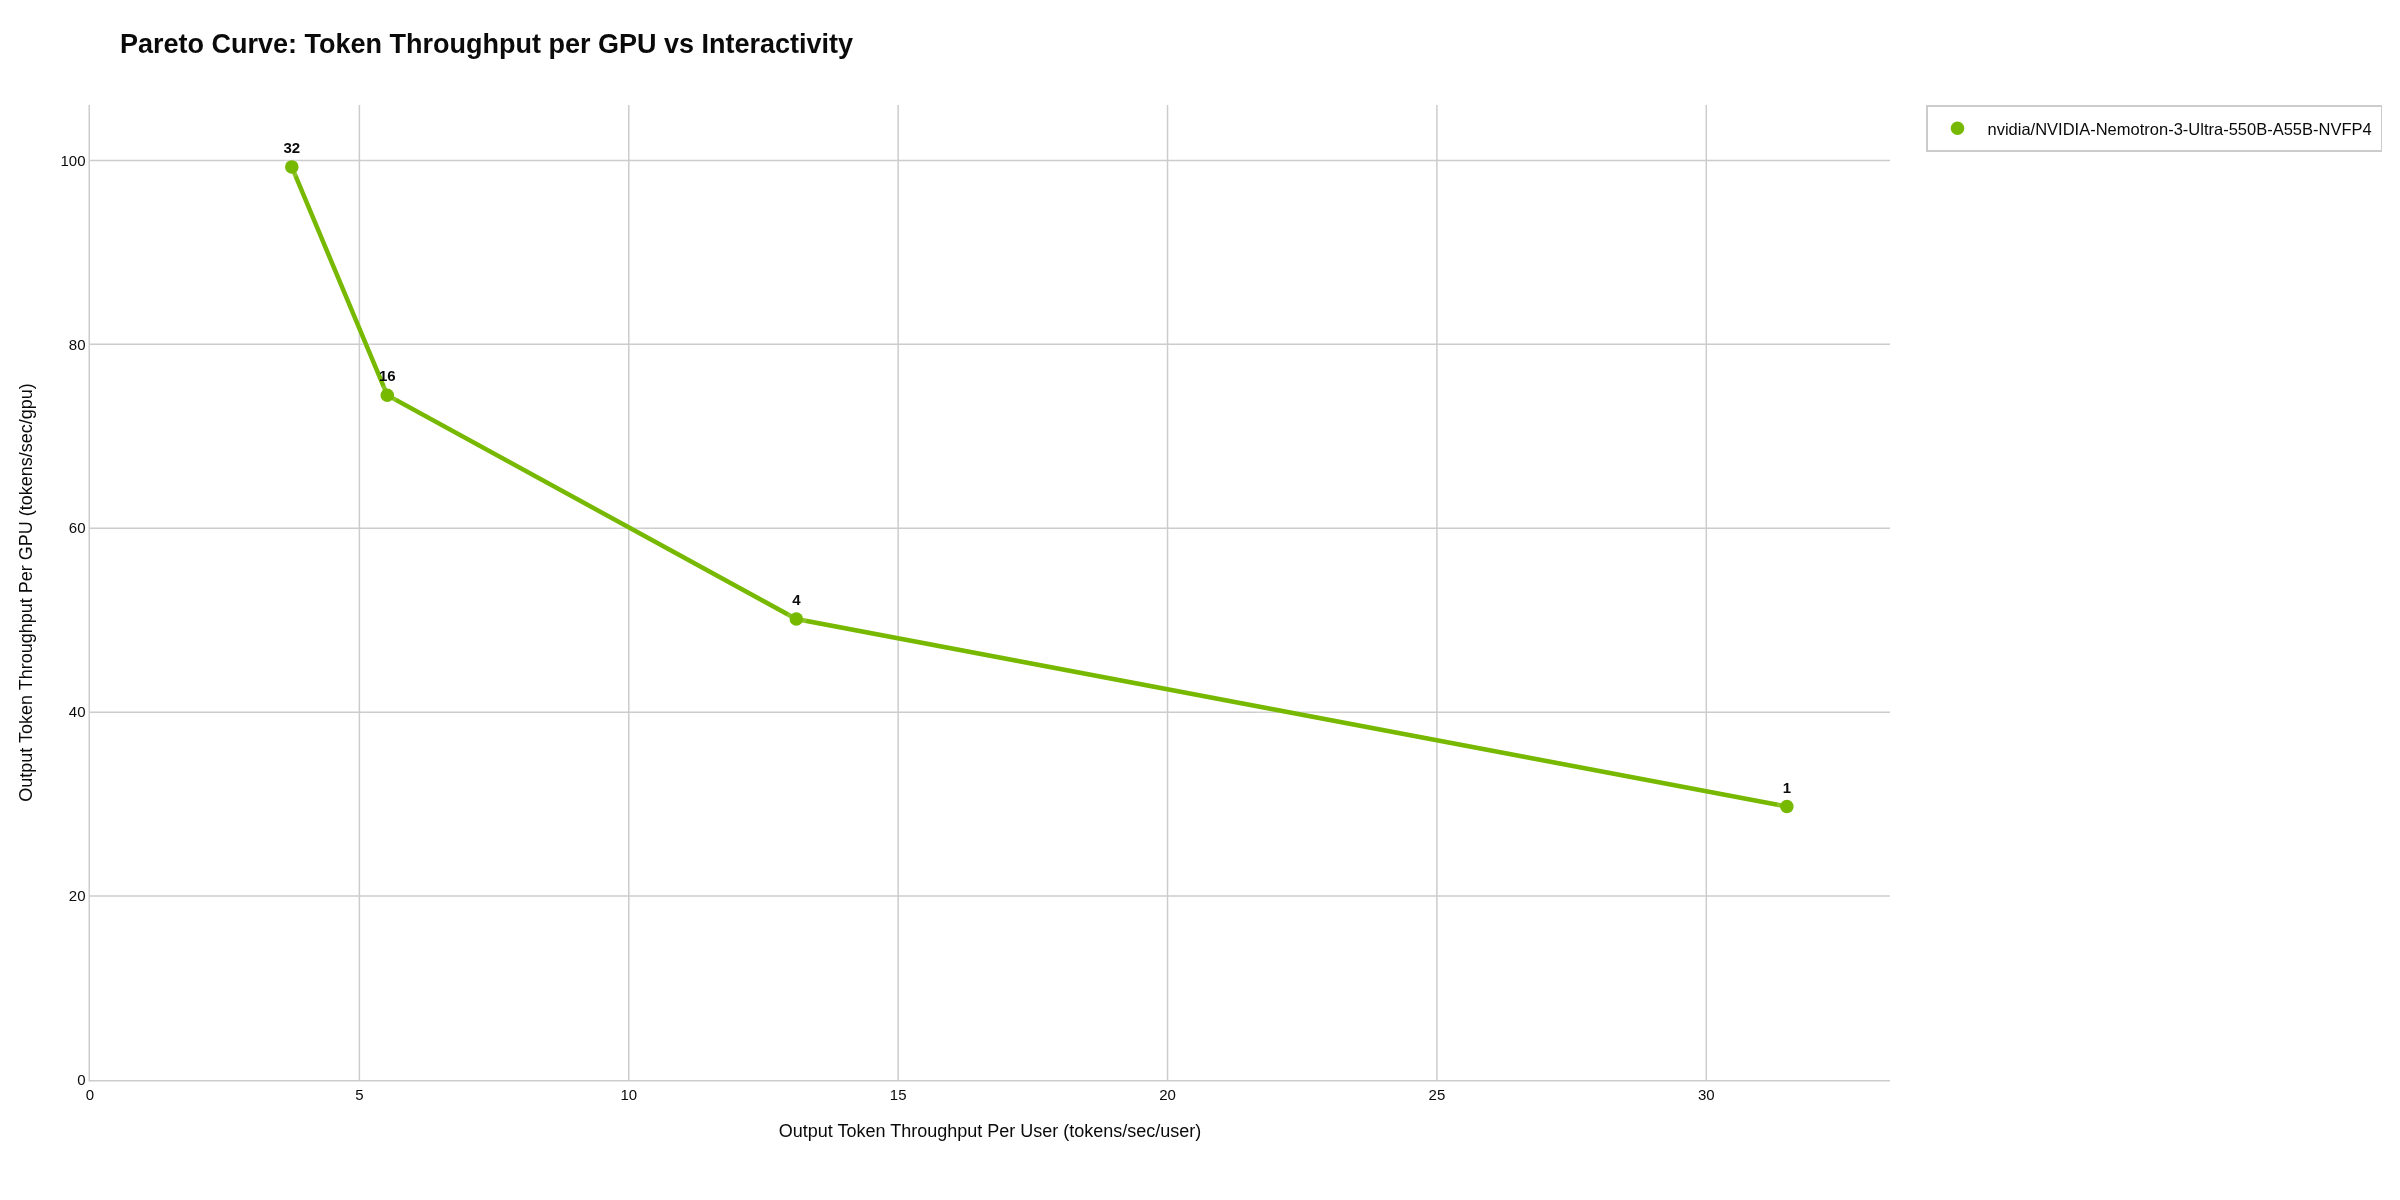
nvidia/NVIDIA-Nemotron-3-Ultra-550B-A55B-NVFP4, Funktion 1: bis zu 32 gleichzeitig aktive Anfragen.
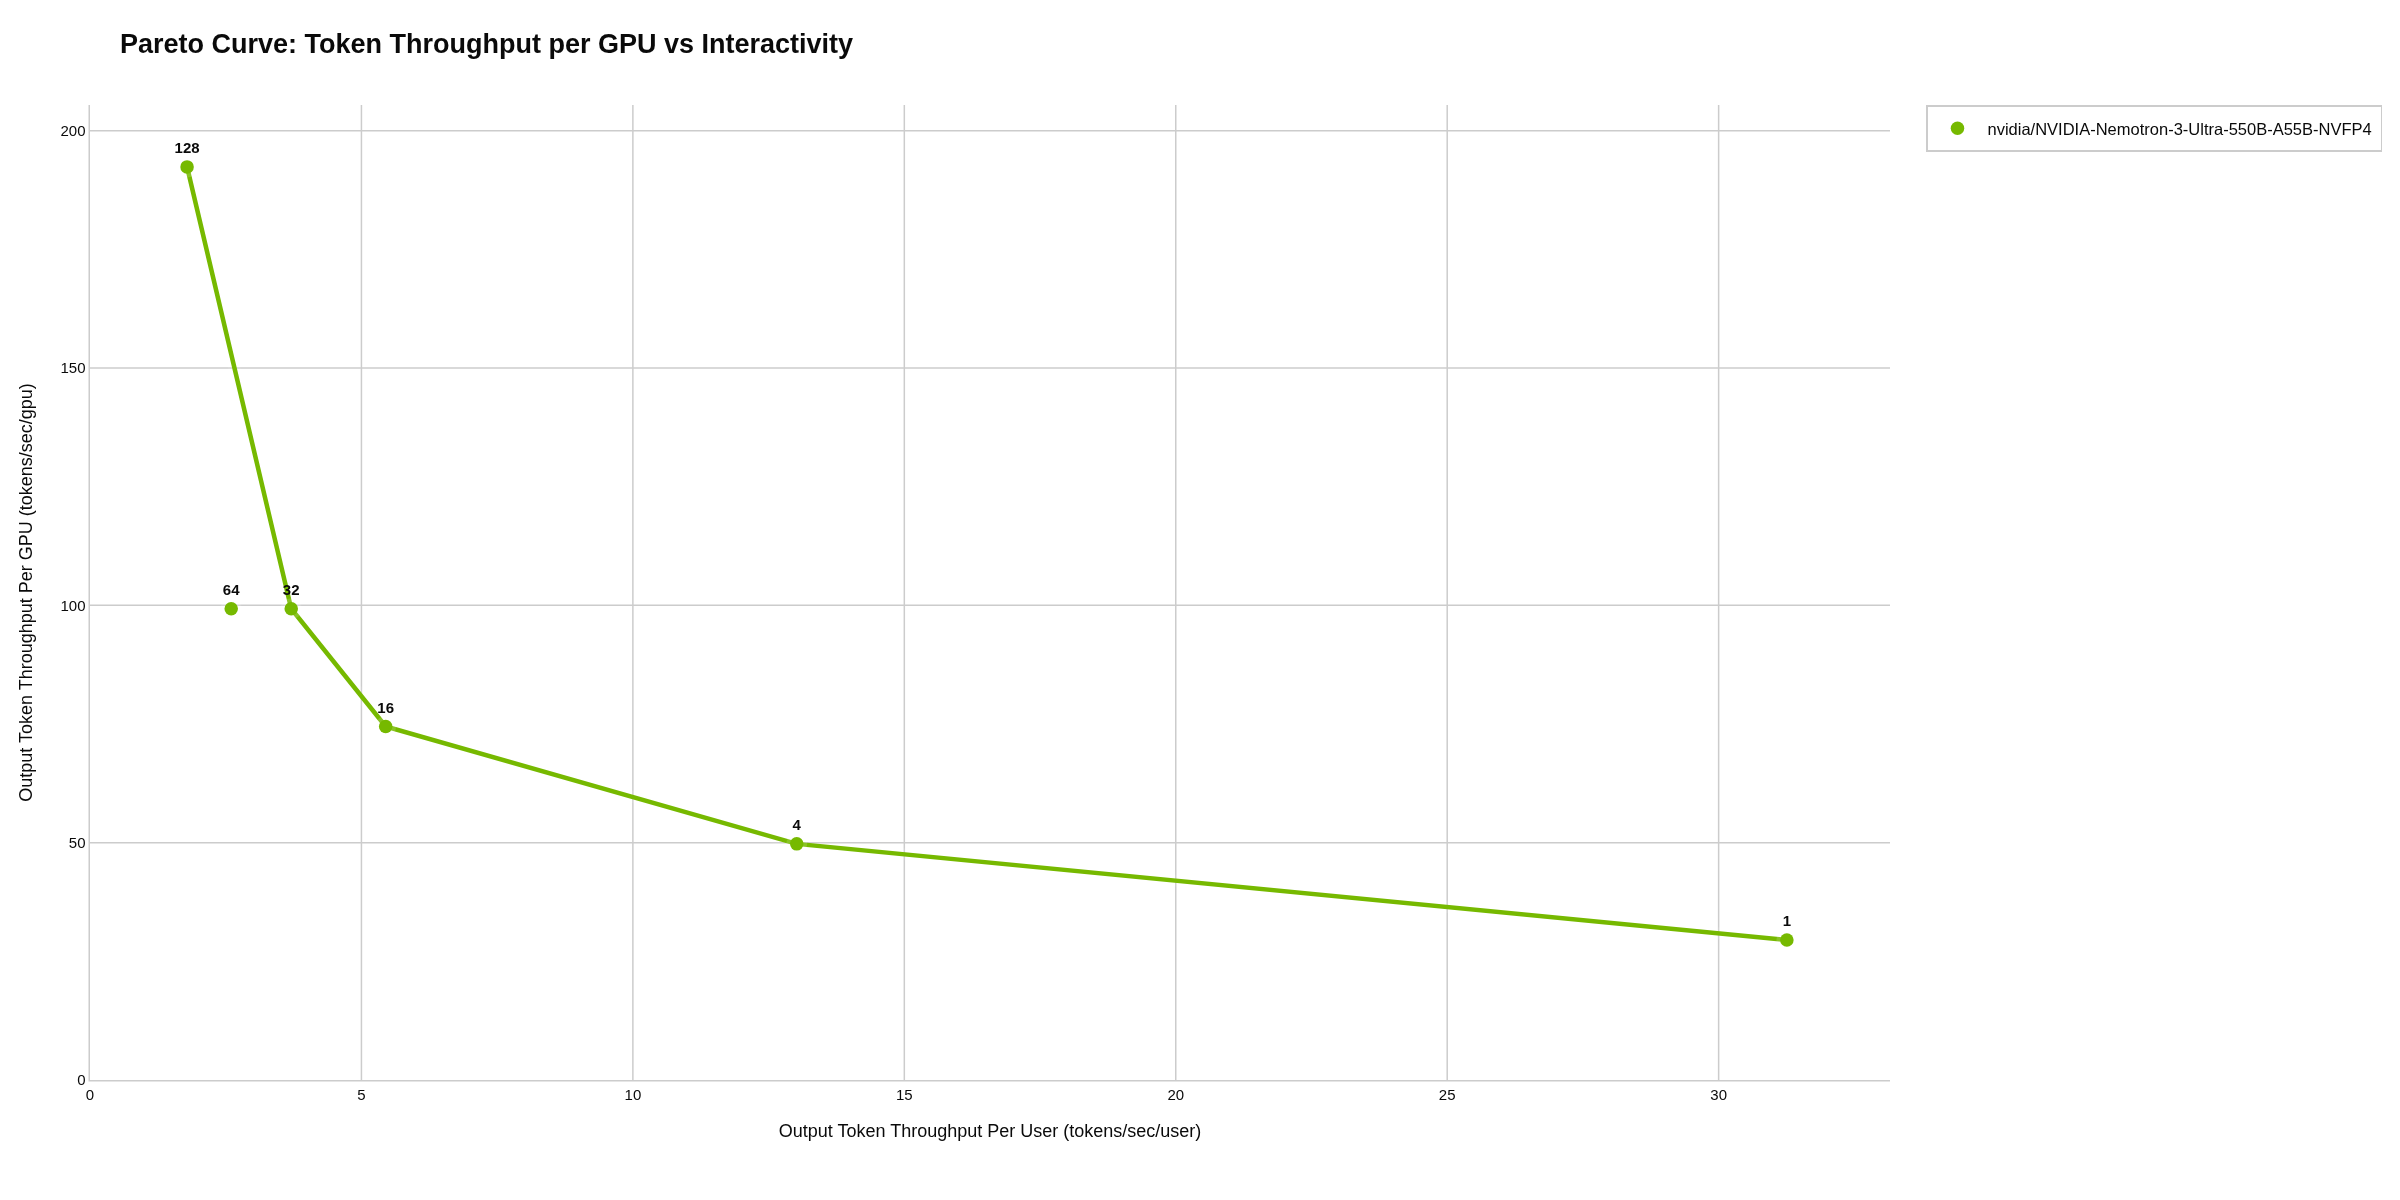
nvidia/NVIDIA-Nemotron-3-Ultra-550B-A55B-NVFP4, Version 2: bis zu 128 gleichzeitig aktive Anfragen.
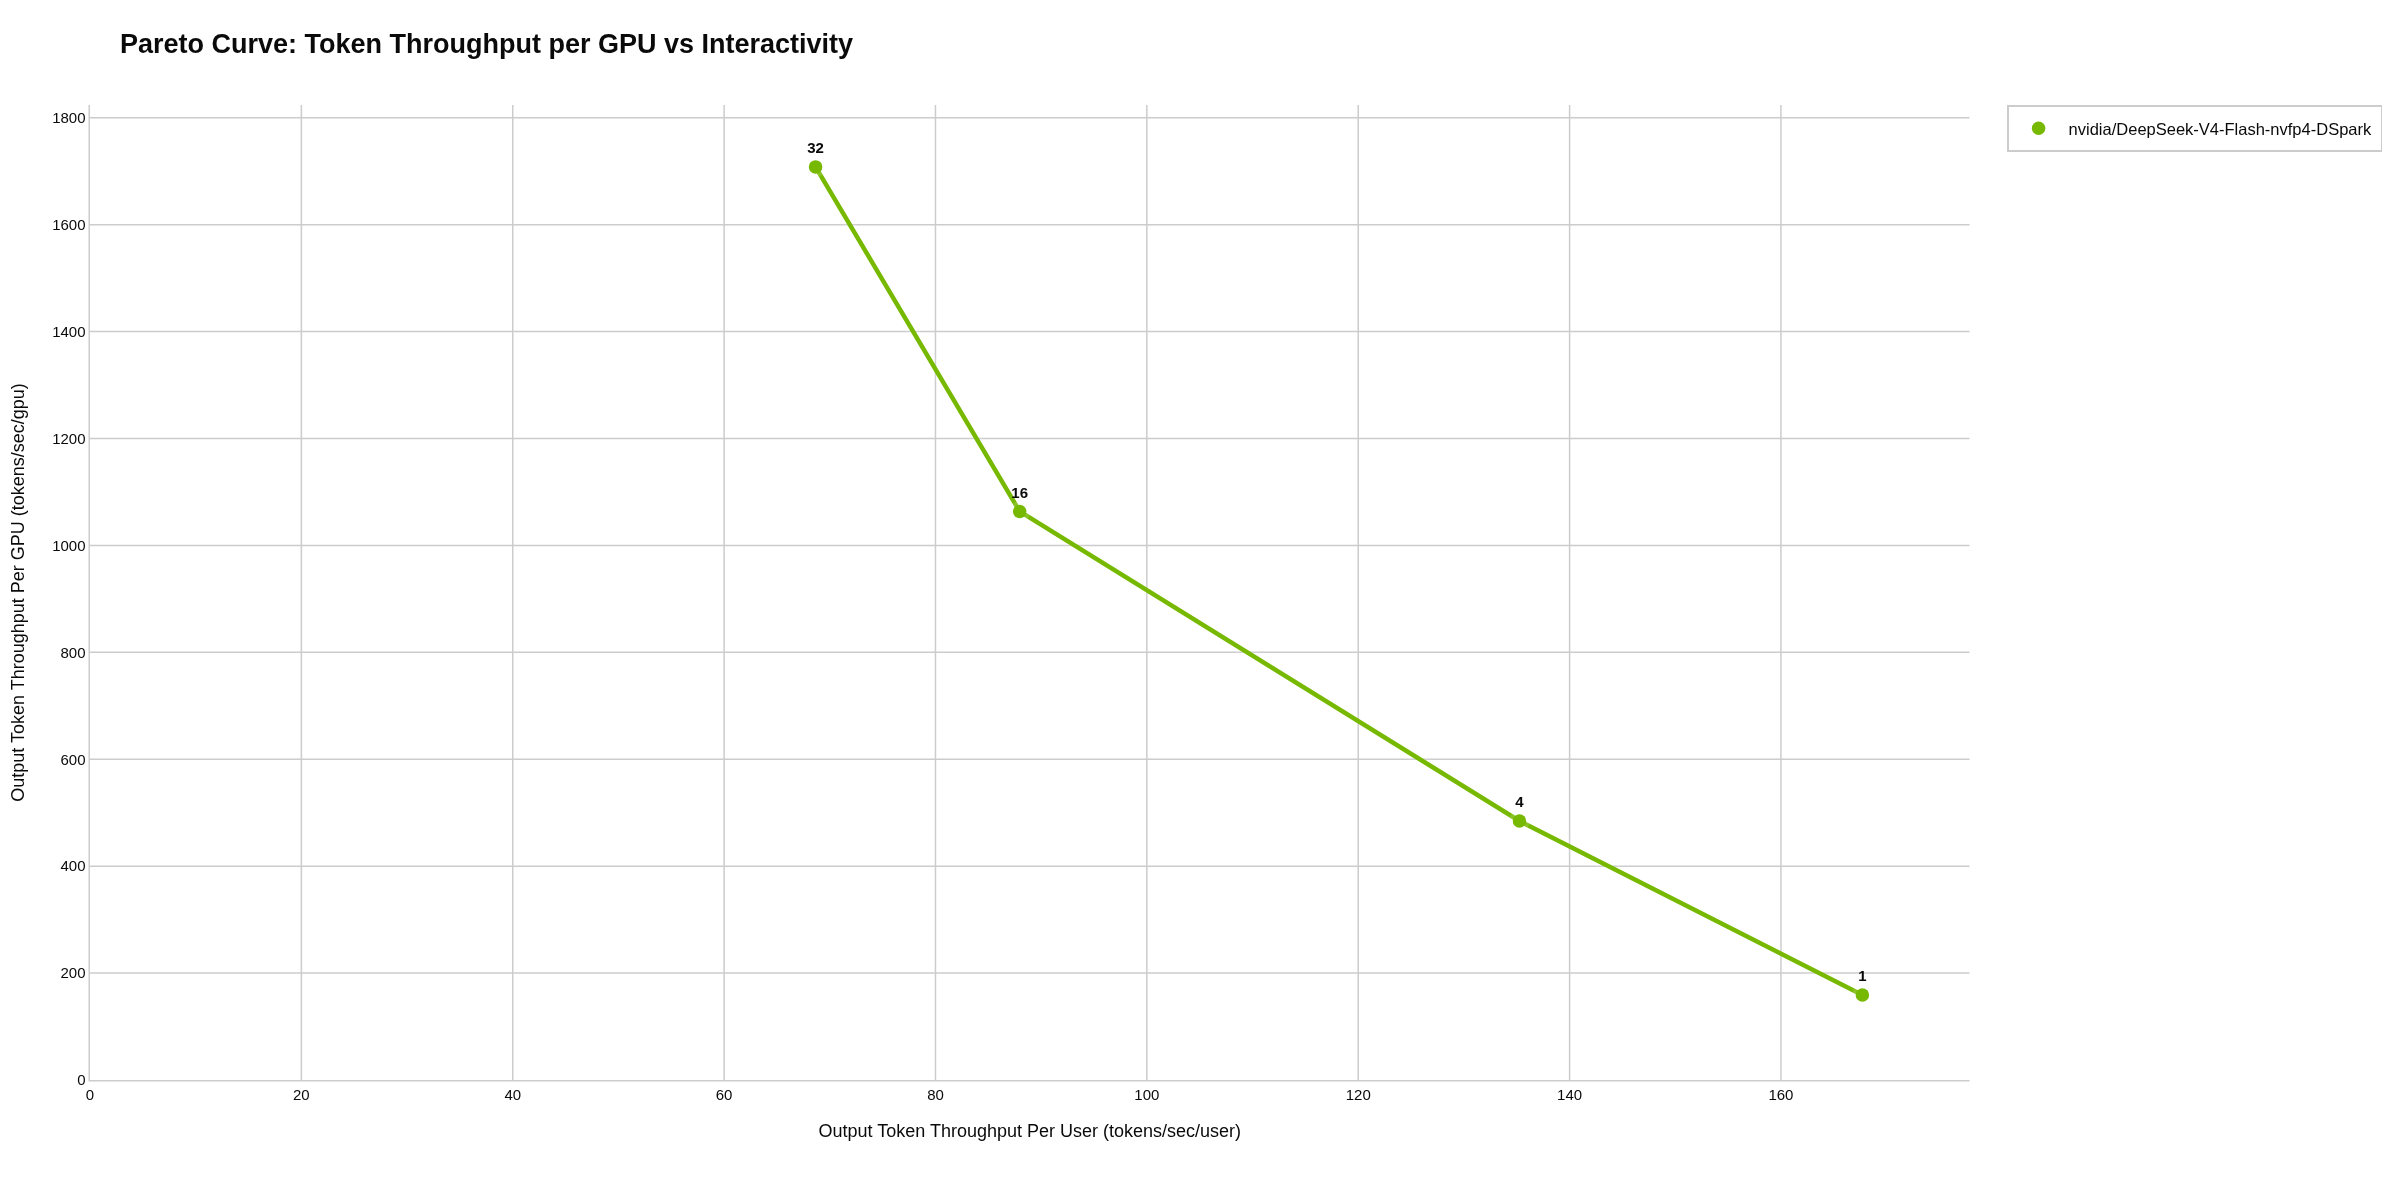
nvidia/DeepSeek-V4-Flash-nvfp4-DSpark, Laufzeit 1: bis zu 32 gleichzeitig aktive Anfragen, keine CPU-Ablastung.
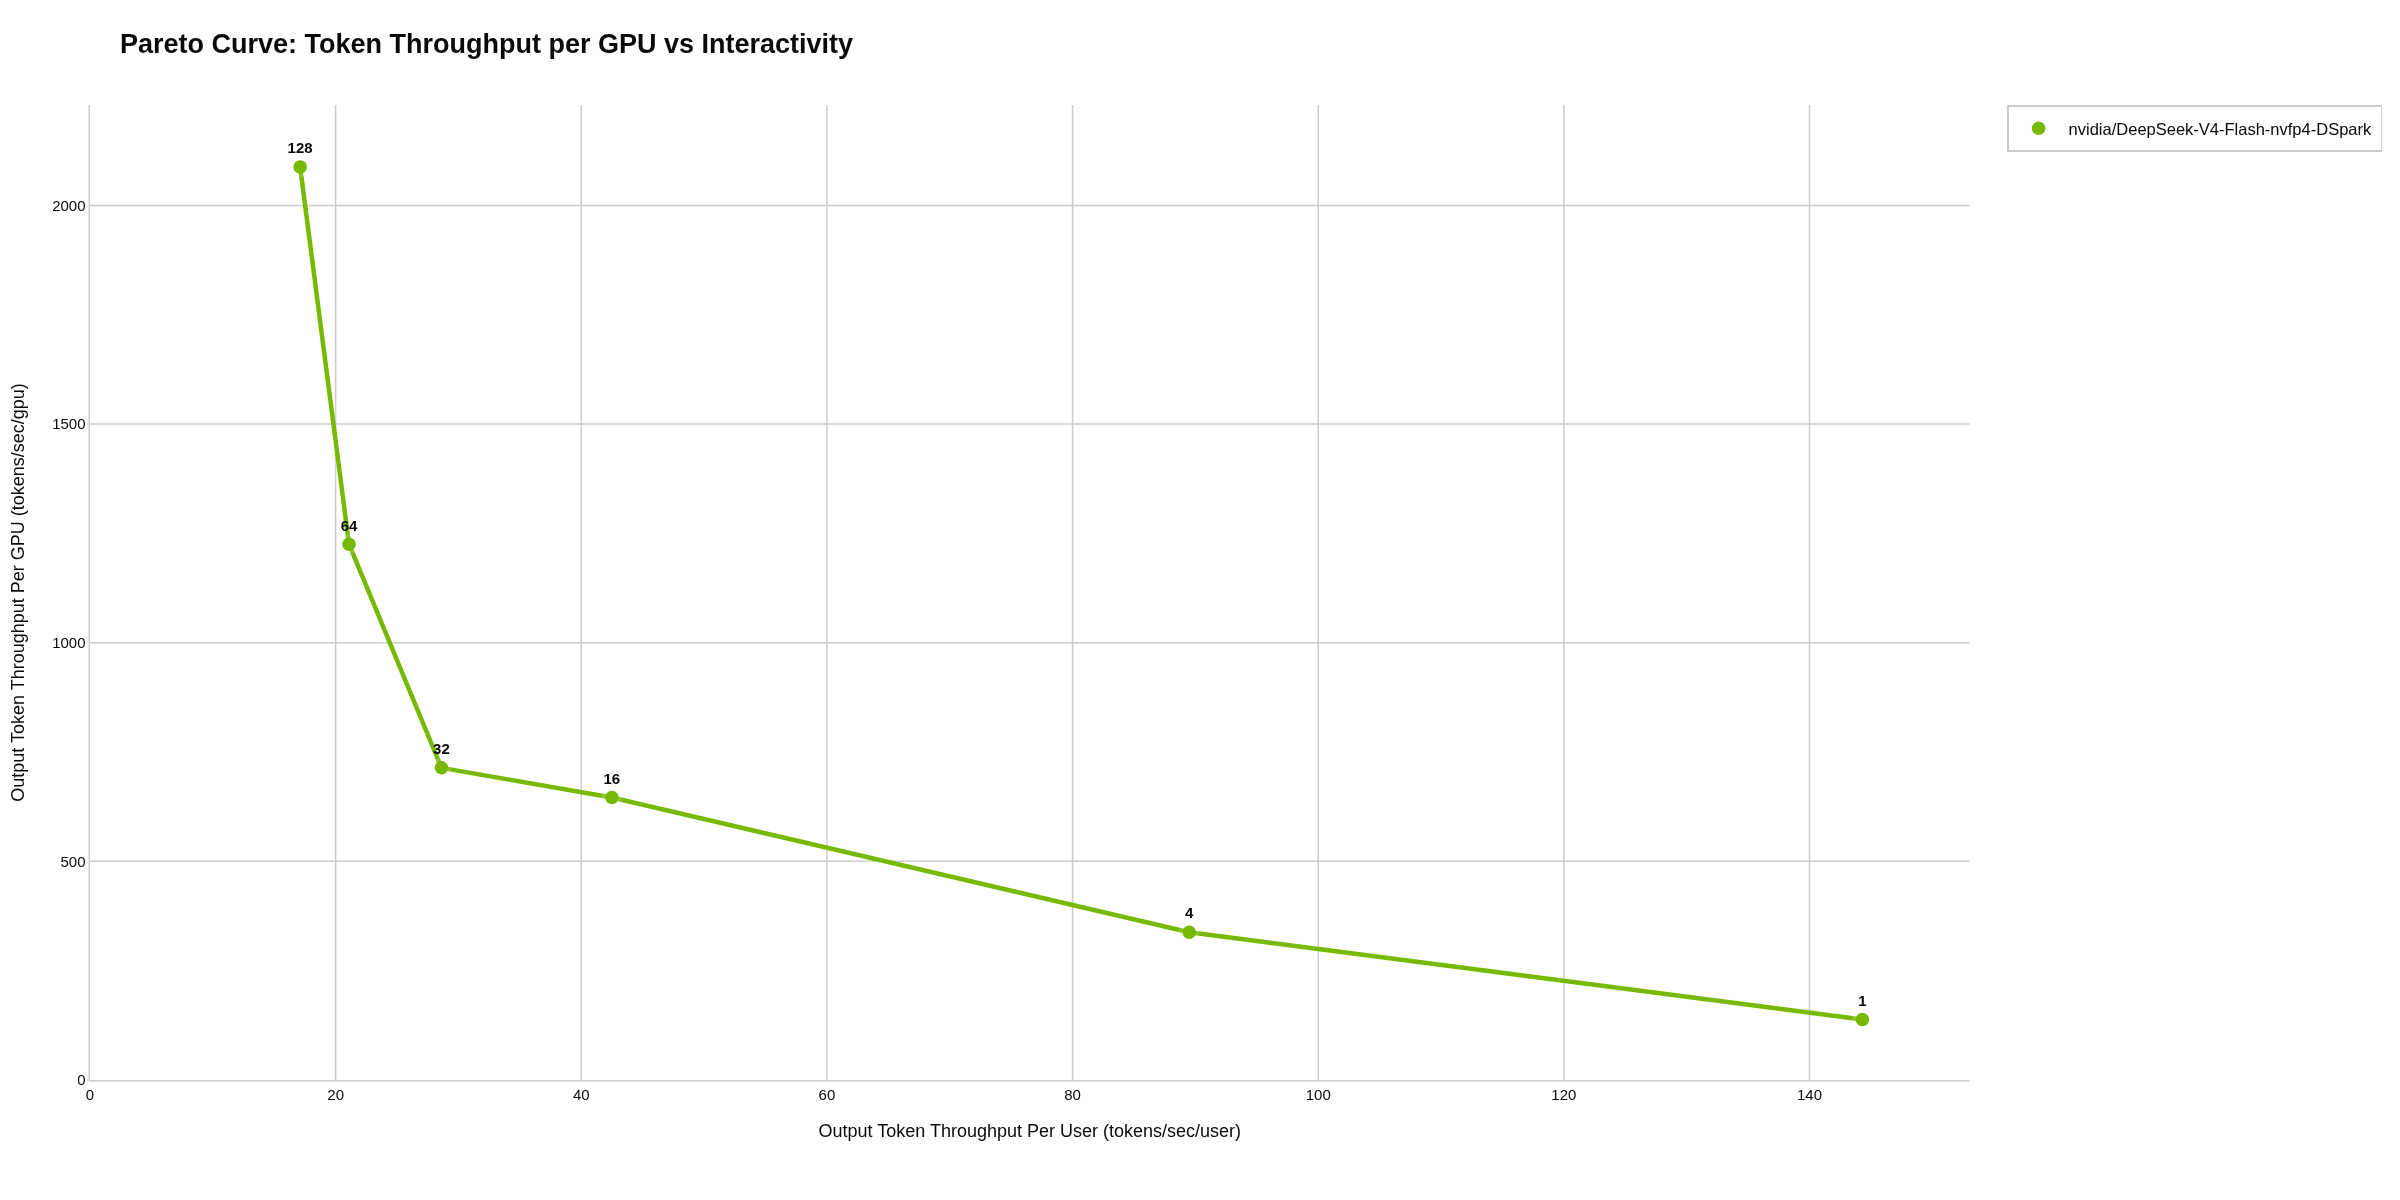
nvidia/DeepSeek-V4-Flash-nvfp4-DSpark, Laufzeit 2: bis zu 128 gleichzeitig aktive Anfragen, 15 GB Expertengewicht in der CPU-Speicher.
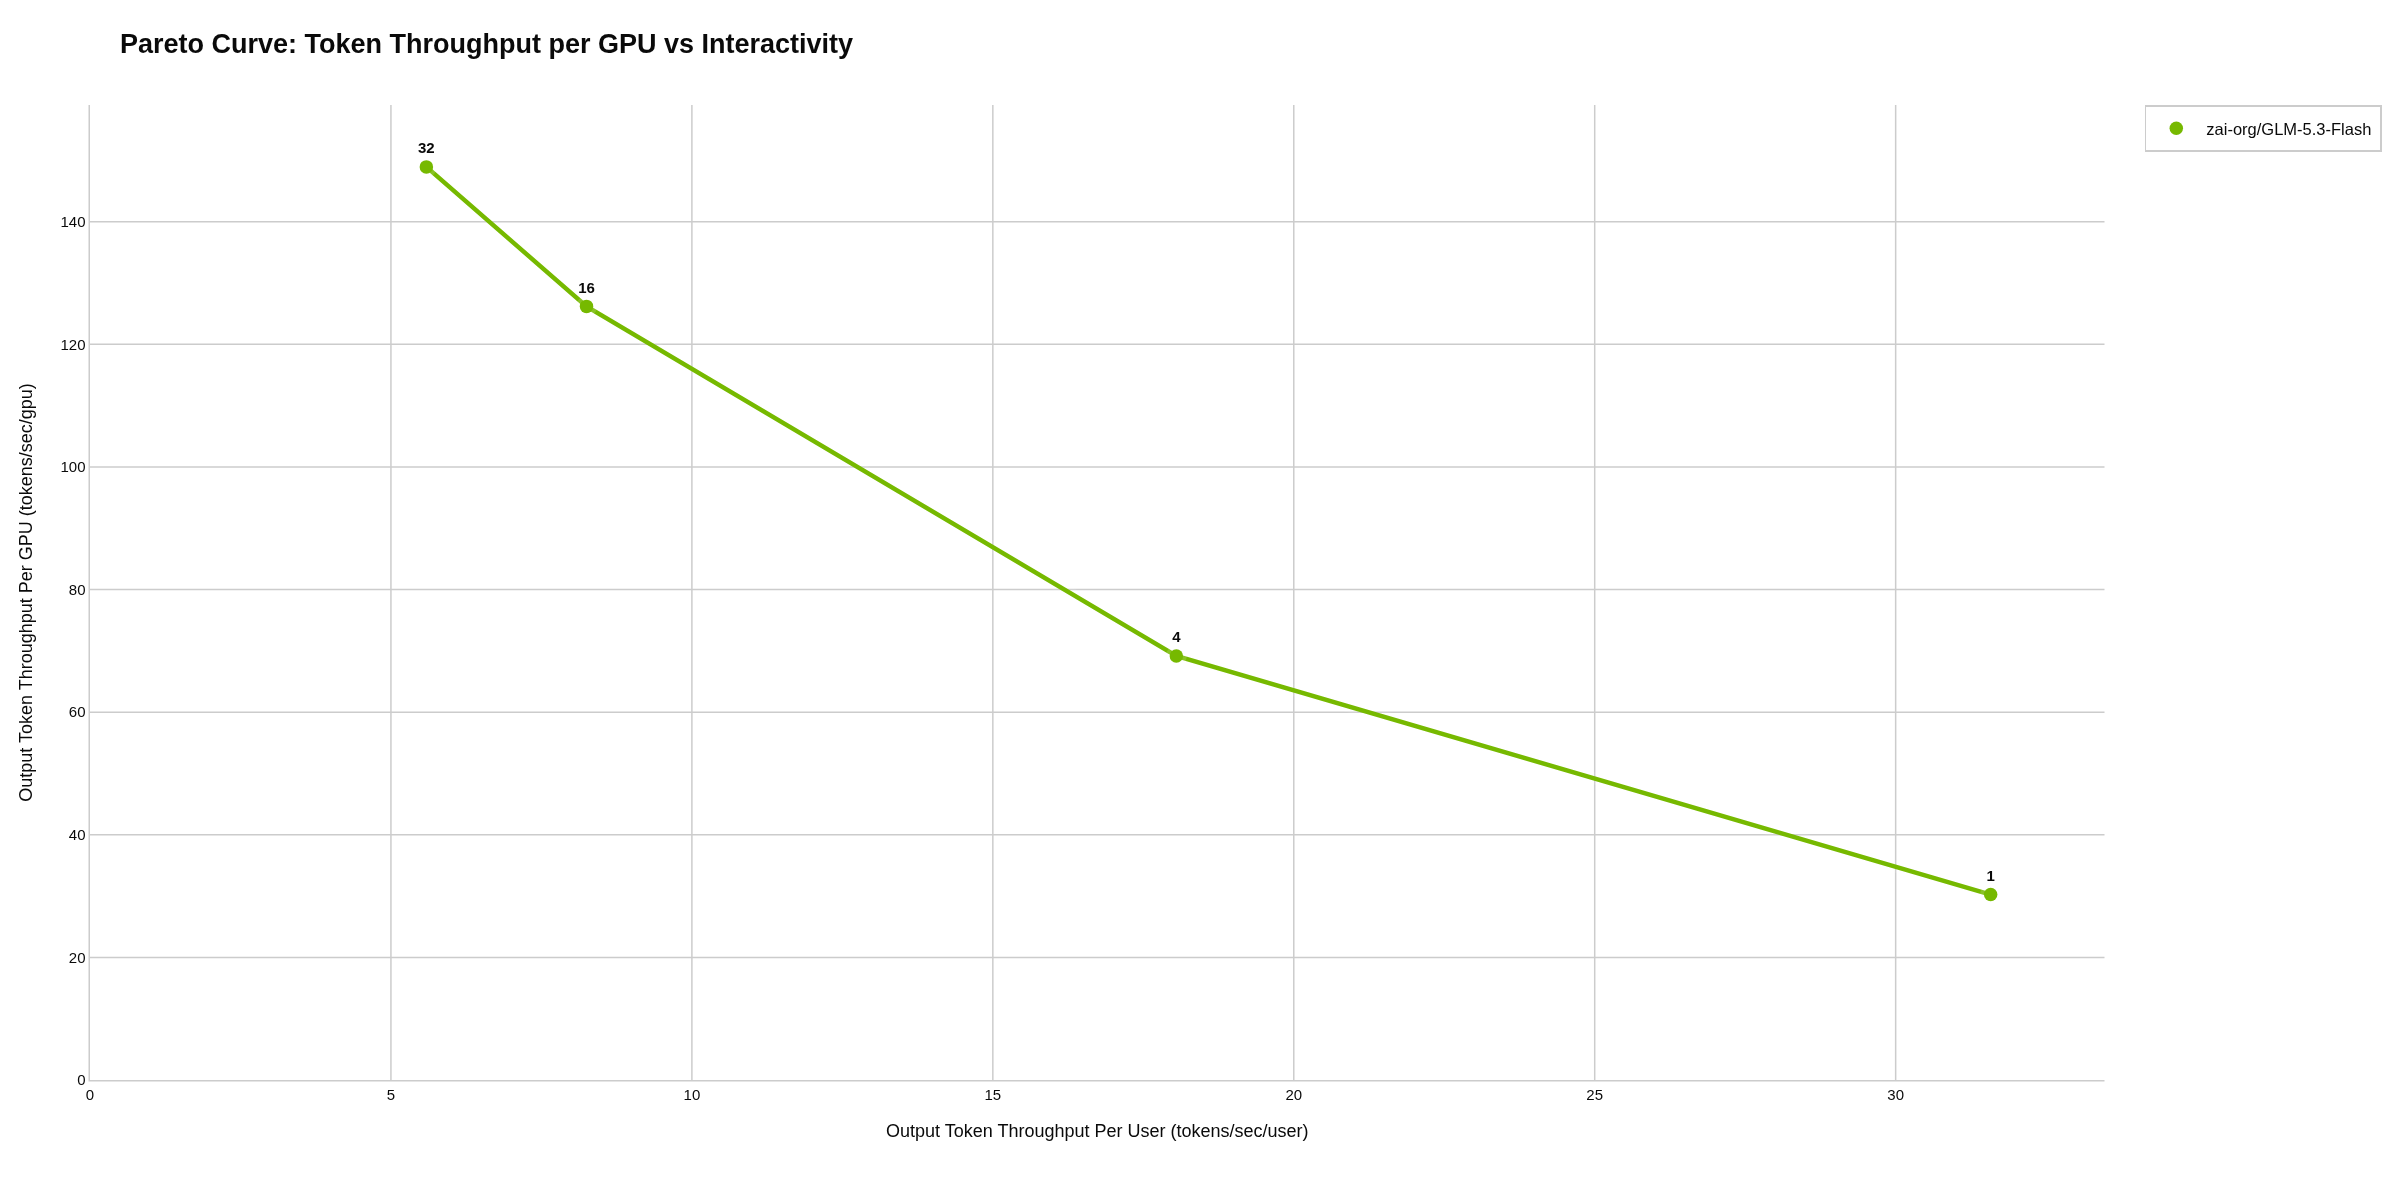
zai-org/GLM-5.3-Flash, Laufzeit 1: bis zu 32 gleichzeitig anfragende Prozesse, 110 GB CPU-Speicher.
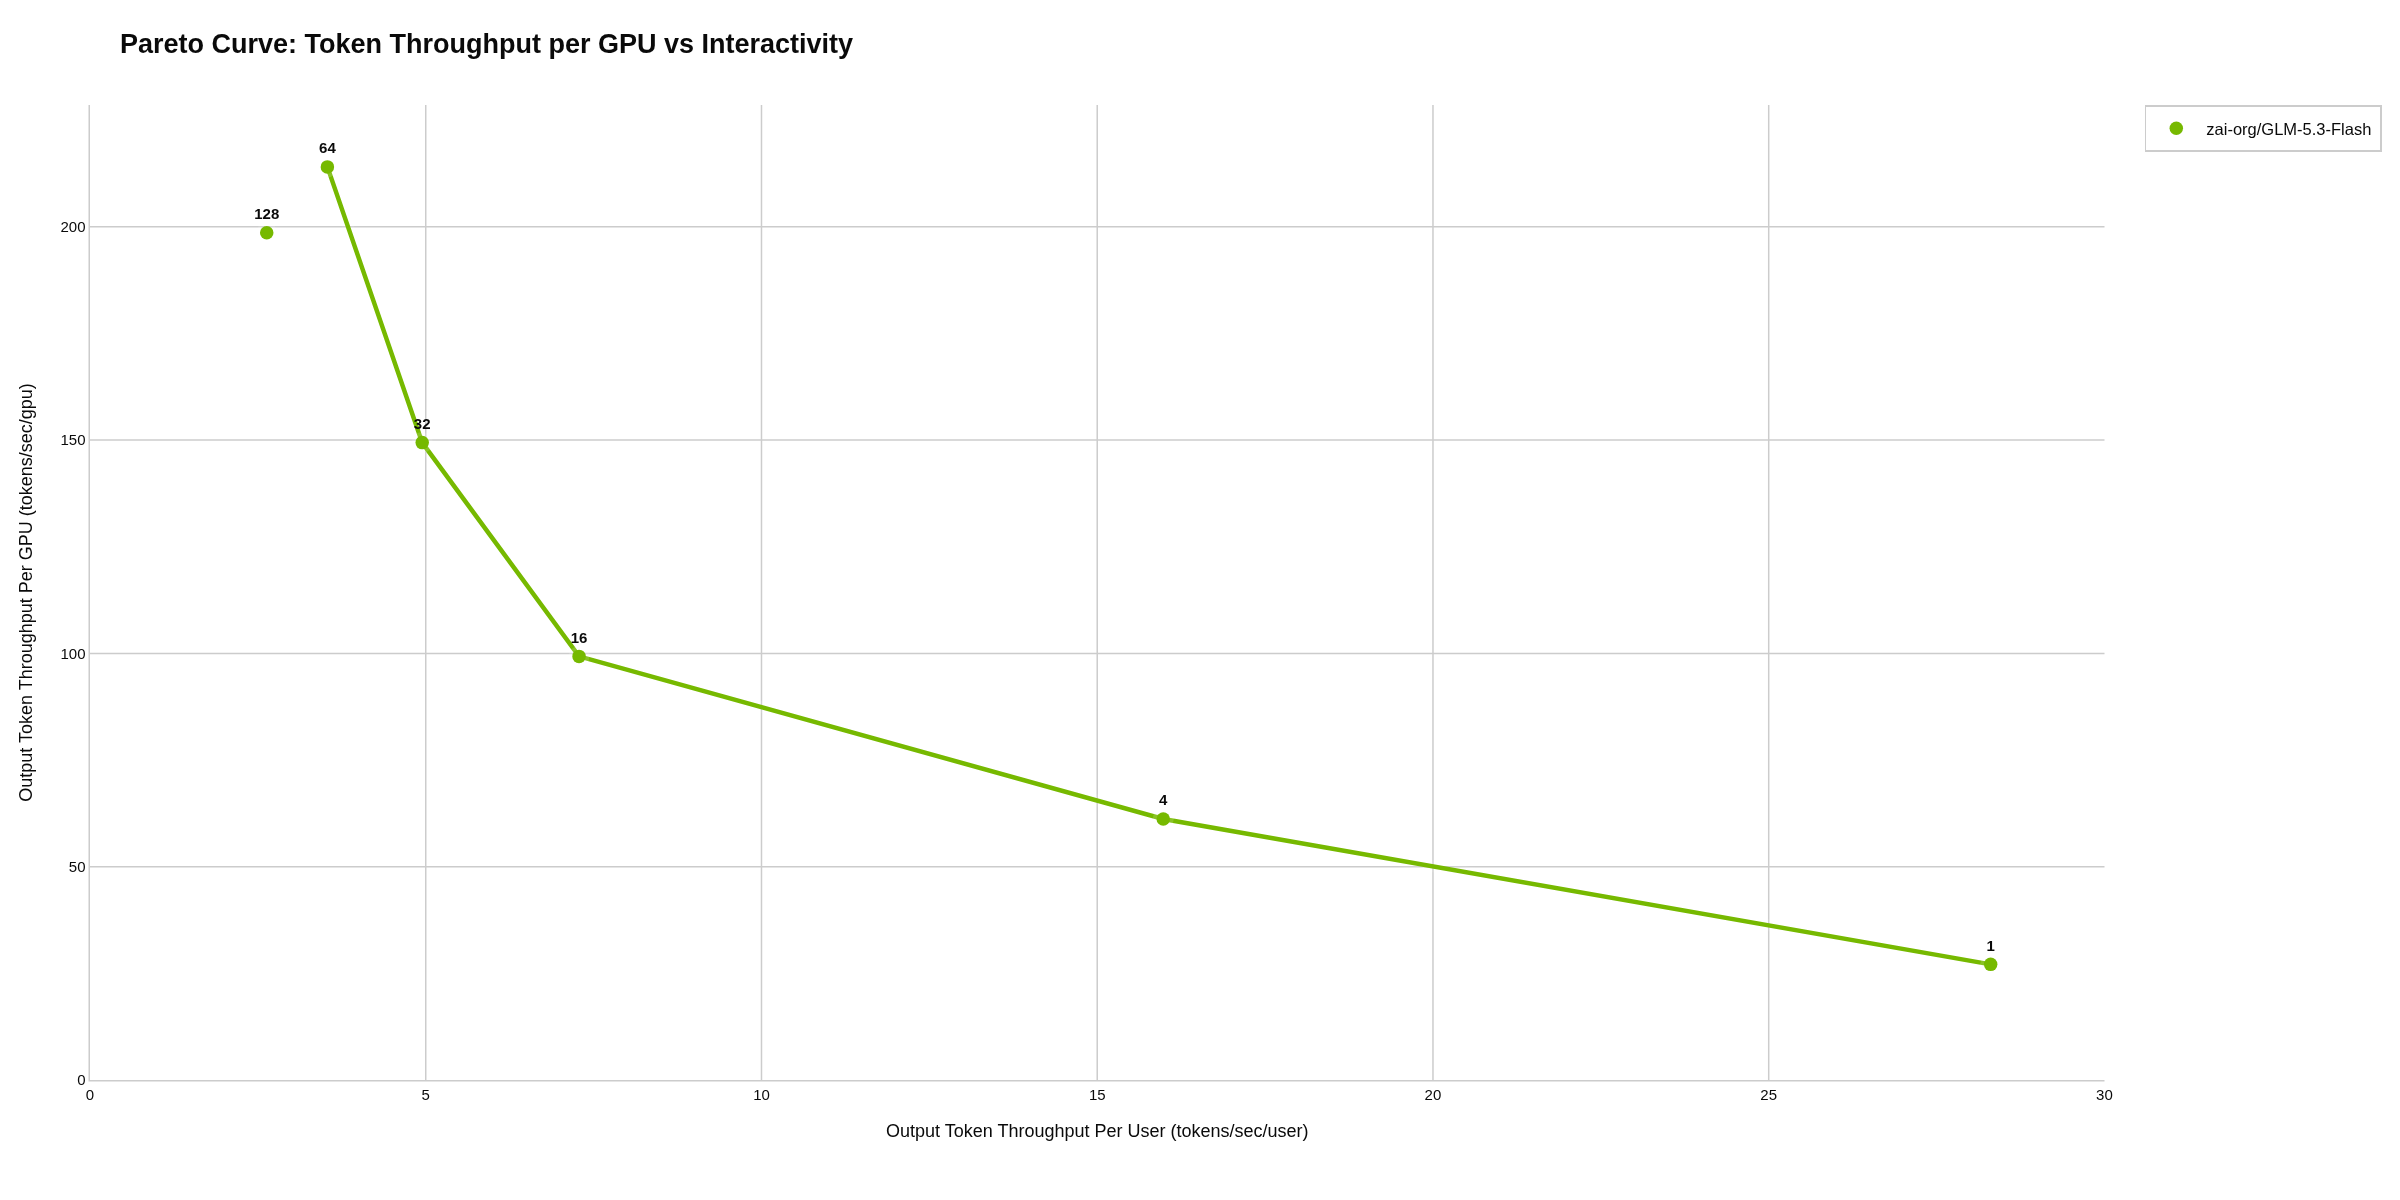
zai-org/GLM-5.3-Flash, Laufzeit 2: bis zu 128 gleichzeitig anfragende Prozesse, 130 GB CPU-Speicher.
Über die fünf Modelle
Wo nur die Anforderungsgrenze sich geändert hatte, reproduzierten sich die Ergebnisse auf den gemeinsamen Laststufen gut, und die höhere Grenze ermöglichte Messungen bei höherer Last. Die beiden Modelle, deren CPU-Offloading geändert wurde, lieferten in Lauf 2 weniger pro Anforderung: zai-org/GLM-5.3-Flash 10 bis 12 % weniger, DeepSeek-V4-Flash 14 bis 59 % weniger; für DeepSeek wurde gleichzeitig die Tool-Call-Parsing-Funktion aktiviert.
Grenzen dieser Vergleiche
Es gibt nur zwei Konfigurationen. Bei zwei Modellen änderte sich mehr als eine Einstellung gleichzeitig, weshalb die Auswirkungen jeder Einstellung nicht getrennt voneinander betrachtet werden können. Jede Laststufe wurde pro Lauf zweimal durchgeführt. Beide Läufe verwendeten dieselben vLLM-Versionen pro Modell (v0.29.0 für die GLM-5.3-Modelle, v0.22.0 für Nemotron-3-Ultra), aber die Nachtbaufassung kann zwischen den beiden Tagen unterschiedlich gewesen sein; ihre genaue Version wurde nicht aufgezeichnet. Die Arbeitslast ist synthetisch und die tatsächlichen Anweisungen und Antworten variieren in der Länge.
Daten
Alle Rohdaten, Konfigurationsdateien und Diagramme befinden sich in den beiden Repositories. Jedes Modell hat seinen eigenen Ordner unter Artefakte/:
| Modell | Run 1 (aiperf_dgx_station_260918) | Run 2 (aiperf_dgx_station_260919) |
|---|---|---|
| MiniMaxAI/MiniMax-M2.7 | 20260917_184420_MiniMaxAI_MiniMax-M2.7_c1,4,16,32,64 | 20260919_015212_MiniMaxAI_MiniMax-M2.7_c1,4,16,32,64,128 |
| RedHatAI/GLM-5.3-Flash-NVFP4 | 20260917_203021_RedHatAI_GLM-5.3-Flash-NVFP4_c1,4,16,32 | 20260919_040943_RedHatAI_GLM-5.3-Flash-NVFP4_c1,4,16,32,64,128 |
| nvidia/NVIDIA-Nemotron-3-Ultra-550B-A55B-NVFP4 | 20260917_230218_nvidia_NVIDIA-Nemotron-3-Ultra-550B-A55B-NVFP4_c1,4,16,32 | 20260919_063709_nvidia_NVIDIA-Nemotron-3-Ultra-550B-A55B-NVFP4_c1,4,16,32,64,128 |
| nvidia/DeepSeek-V4-Flash-nvfp4-DSpark | 20260917_194410_nvidia_DeepSeek-V4-Flash-nvfp4-DSpark_c1,4,16,32 | 20260919_030210_nvidia_DeepSeek-V4-Flash-nvfp4-DSpark_c1,4,16,32,64,128 |
| zai-org/GLM-5.3-Flash | 20260917_211657_zai-org_GLM-5.3-Flash_c1,4,16,32 | 20260919_051813_zai-org_GLM-5.3-Flash_c1,4,16,32,64,128 |
Wenn Sie planen, ein großes Modell auf der DGX Station zu betreiben und wissen möchten, wie bestimmte Einstellungen Ihre Workload beeinflussen, würden wir uns freuen, Ihre Anforderungen zu hören. Wir können die von Ihnen erwogenen Konfigurationen vergleichen und Ihnen helfen, zu beurteilen, was die Ergebnisse für Ihren Anwendungsfall bedeuten.
 Deutsch (Sie)
 English