DGX Spark-Benchmarking der Schlussfolgerungsverarbeitungsleistung von 14 offenen Gewichtsmodellen
Der DGX Spark verfügt über 128 GB Speicher, den die CPU und die GPU gemeinsam nutzen. Das reicht aus, um ein Modell mit 120 Milliarden Parametern in 4-Bit-Auflösung zu speichern. Was dieser Speicher Ihnen nicht verrät, ist die Geschwindigkeit, mit der diese Modelle antworten, und wie sich diese Geschwindigkeit verändert, wenn gleichzeitig mehr als eine Anfrage eingeht.
Um die Leistung des DGX Spark zu bewerten, habe ich 14 Modelle mit offener Last auf diesem System getestet – von einem kleinen Gemma-Modell über ein Nemotron mit 120 Milliarden Parametern bis hin zu einem Modell mit sechs Laststufen zwischen 1 und 32 parallelen Anfragen. In diesem Artikel werden die Messwerte dargelegt, die ich durchgeführt habe. Weitere Artikel in dieser Reihe behandeln das DGX Station; dieser Artikel beschreibt lediglich das DGX Spark.
Wie ich die DGX Spark bewertet habe
Ich habe verwendet aiperf_tool, ein kleiner Harness, den ich um den Benchmark-Client AIPerf von NVIDIA und den vLLM-Inferenzserver gebaut habe. Jedes Modell läuft in einem eigenen vLLM-Container, und der Benchmark sendet Anfragen mit der gleichen Größe: einen Befehl mit 1.024 Zeichen (ein wenig mehr, wenn er in die Chat-Vorlage jedes Modells eingebettet ist) und genau 512 Ausgabetoken. Das Modell darf nicht vorzeitig stoppen, daher erledigt jede Anfrage dieselbe Arbeit. Jedes Ladevorgangsspektrum dauert fünf Minuten.
Die Belastung wird als gleichzeitige Anfragen angegeben. Jede gleichzeitige Anfrage ist ein Slot, der seine nächste Anfrage sendet, sobald die vorherige Antwort abgeschlossen ist, ohne die Pausen, die eine Person für das Lesen und Tippen benötigt.
Der Benchmark misst die Geschwindigkeit: wie viele Tokens das System insgesamt generiert, wie schnell jede einzelne Antwortströme und wie lange es dauert, bis eine Antwort beginnt (die Zeit bis zum ersten Token). Es misst nicht die Antwortqualität und wurde ohne spekulativen Dekodierung durchgeführt.
| System | NVIDIA DGX Spark (GB10), 128 GB Unified Memory |
| Modelle | 14 |
| Zusammengesetzte Anfragen | 1, 2, 4, 8, 16, 32 (Nemotron-3-Super: bis zu 16) |
| Laufkilometer pro Lastniveau | 1 |
| Inferenzserver | vLLM v0.29.0, 80 % Speicher, FP8 KV-Cache |
| Arbeitsaufwand | 1.024 Eingabesteuerelemente / 512 Ausgabesteuerelemente, 5 Minuten pro Level |
| Daten | aiperf_dgx_spark_260917 |
So lesen Sie die Diagramme in diesem Artikel
Die in diesem Artikel dargestellten Diagramme sind Pareto-Kurven, die AIPerf für jedes Modell generiert. Hier ist nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4:
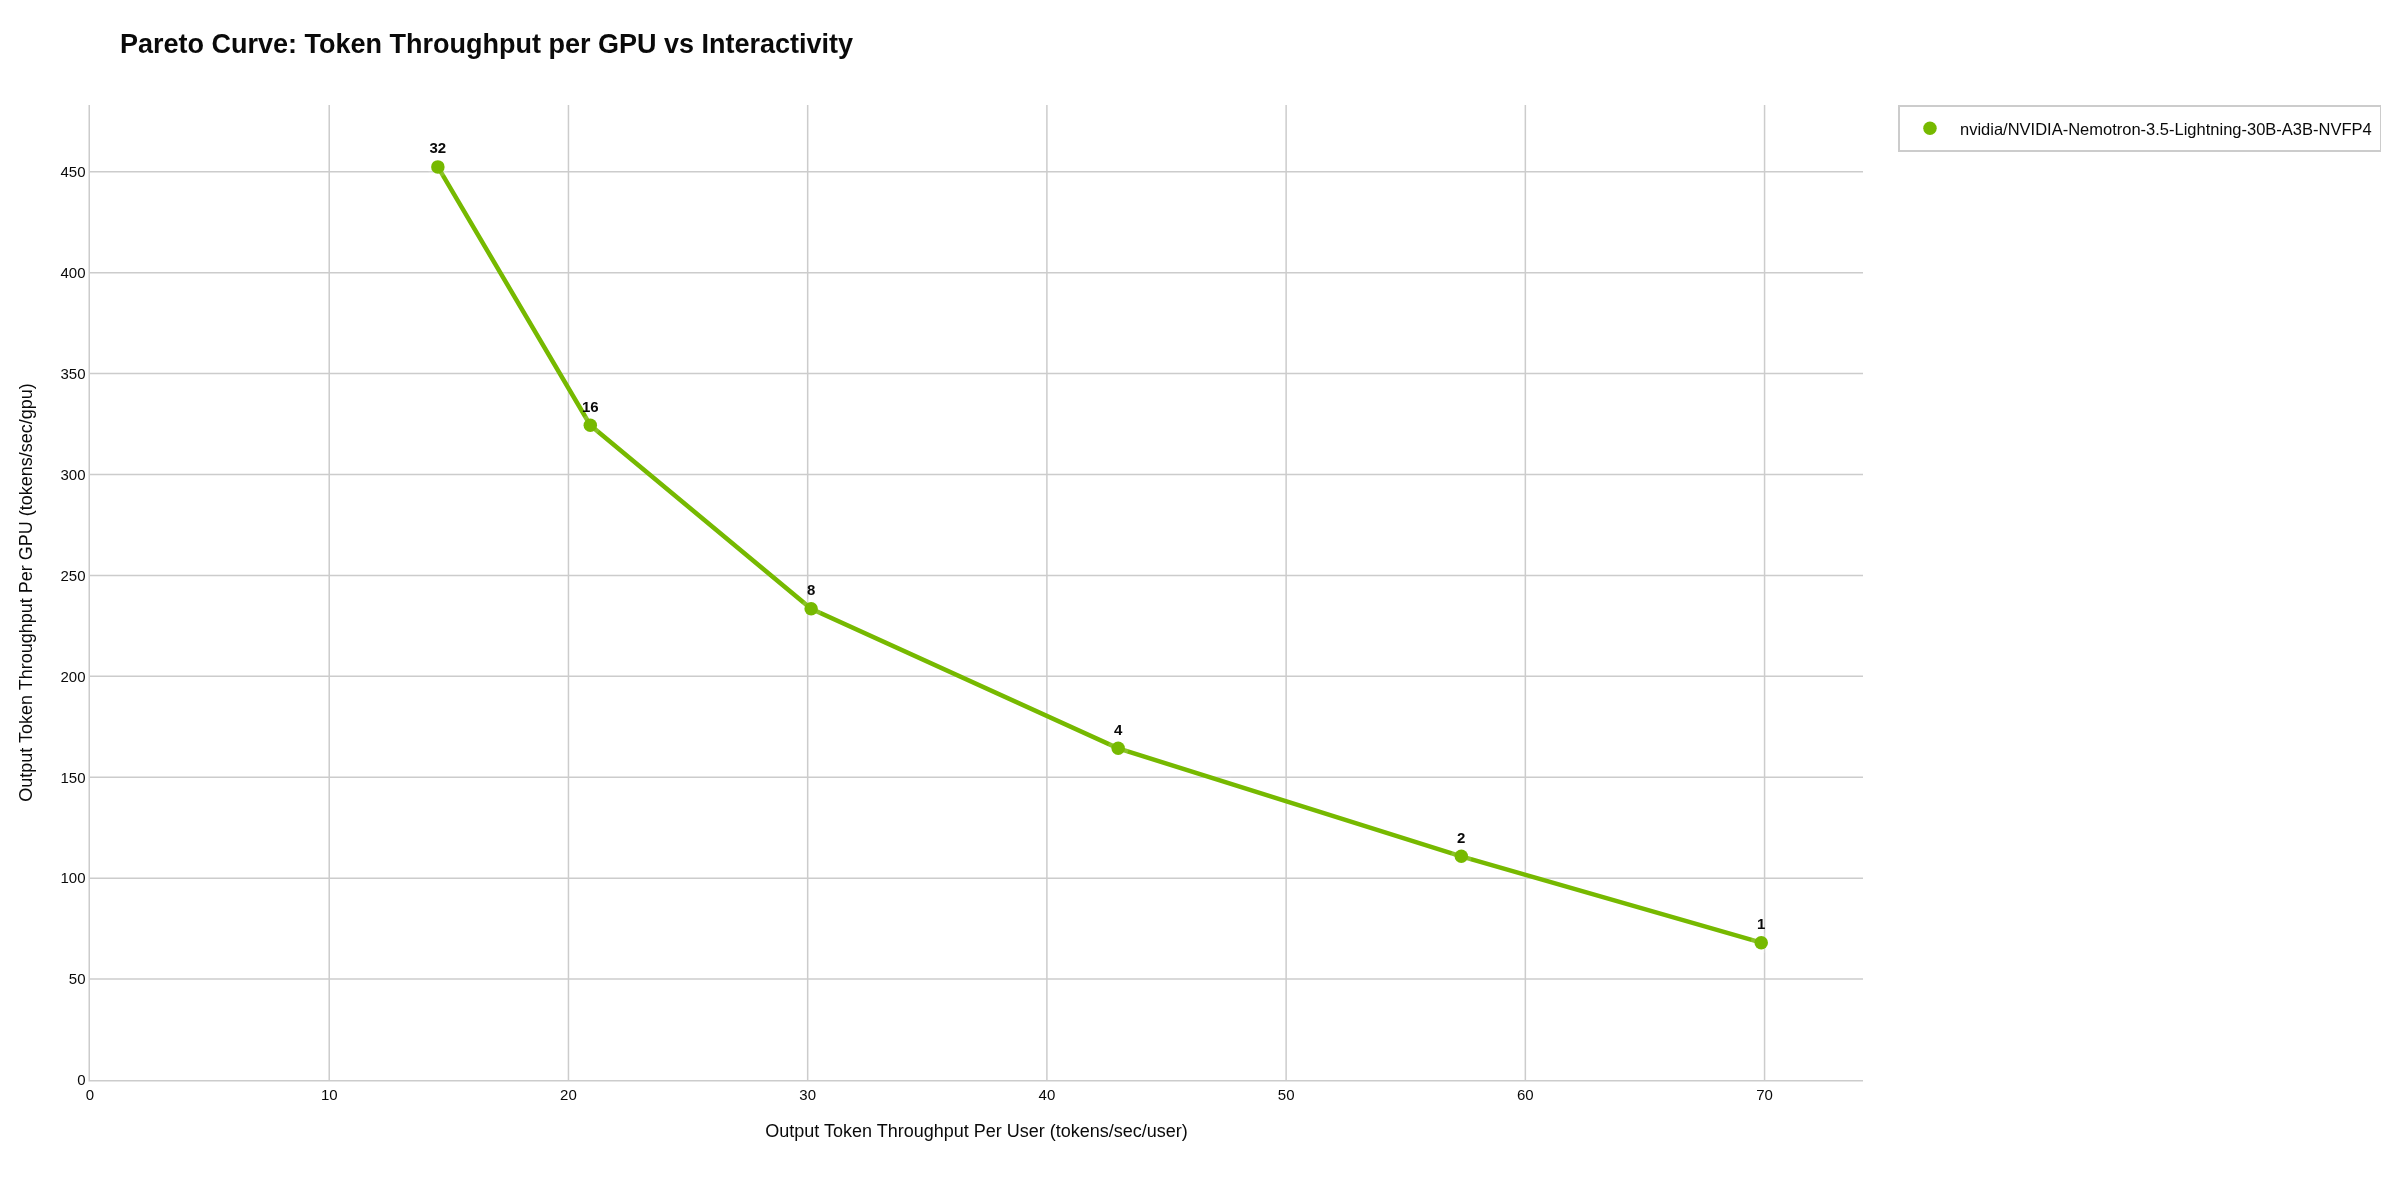
Die vertikale Achse ist die Gesamtausgabe in Tokens pro Sekunde. Der Spark verfügt über eine einzige GPU, daher lautet “per GPU” einfach die Gesamtzahl. Die horizontale Achse gibt an, wie schnell eine Antwortströme anfallen, in Tokens pro Sekunde pro Anforderung (AIPerf bezeichnet dies als “per User”). Jeder Punkt entspricht einer Belastungsstufe, und die Zahl neben diesem Punkt gibt die Konkurrentenz an.
Bei 1 gleichzeitigem Anforderungssignal strömt dieses Modell auf der äußersten rechten Spalte eine Antwort mit einer Geschwindigkeit von etwa 70 Tokens pro Sekunde. Bei fortschreitender Bewegung nach links steigt die Konkurrentenz: Bei 32 gleichzeitigem Anforderungssignal fließen jeweils jeweils etwa 15 Tokens pro Sekunde, während das System insgesamt etwa 450 generiert. Die Linie verbindet die Laststufen, die auf beiden Achsen gleichzeitig nicht übertroffen werden können; ein Punkt außerhalb der Linie weist sowohl eine niedrigere Gesamtzuführung als auch langsamerere Antworten auf als eine andere Laststufe. Die Skalierungsachsen passen sich an jedes Modell an, daher sollten Sie sie überprüfen, bevor Sie zwei Diagramme miteinander vergleichen.
Alle 14 Modelle, die ich auf dem DGX Spark getestet habe
| Modell | Architektur | Präzision | Größe | 1 Anfrage: tok/s, TTFT | 16 simultane Anfragen: tok/s pro Anfrage, insgesamt | 32 simultane: tok/s pro Anfrage, insgesamt | Gesamtsumme (at) |
|---|---|---|---|---|---|---|---|
| google/gemma-4-E4B-it | dicht, klein | BF16 | 15 GB | 18,5, 0,26 s | 20.2, 317 | 18.4, 569 | 569 (32) |
| google/gemma-4-E4B-it-qat-w4a16-ct | dicht, klein | 4-Bit QAT | 11 GB | 50,6, 0,23 s | 43.1, 667 | 34.9, 1,075 | 1,075 (32) |
| google/gemma-4-26B-A4B-it | MoE, Aktivität 4B | BF16 | 48 GB | 23,2, 0,41 s | 9.1, 124 | 7.0, 199 | 199 (32) |
| nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4 | MoE, 3B aktiv | NVFP4 | 20 GB | 69,9, 0,22 s | 20.9, 324 | 14.6, 452 | 452 (32) |
| nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4 | MoE, 12B aktiv | NVFP4 | 75 GB | 15,7, 0,70 s | 5.1, 80 | nicht getestet | 80 (16) |
| ibm-granite/granite-4.2-30b | dicht, 30B | BF16 | 55 GB | 3,9, 0,92 s | 3.5, 50 | 3.1, 50 | 50 (16 und 32) |
| Qwen/Qwen3.6-35B-A3B | MoE, 3B aktiv | BF16 | 67 GB | 29,8, 0,40 s | 9.4, 124 | 6.6, 204 | 204 (32) |
| nvidia/Qwen3.6-35B-A3B-NVFP4 | MoE, 3B aktiv | NVFP4 | 22 GB | 76,4, 0,19 s | 22.8, 351 | 15.0, 462 | 462 (32) |
| Qwen/Qwen3.6-27B | dicht, 27B | BF16 | 52 GB | 4,4, 0,92 s | 3.7, 50 | 3.1, 50 | 50 (16 und 32) |
| nvidia/Qwen3.6-27B-NVFP4 | dicht, 27B | NVFP4 | 20 GB | 12,0, 0,95 s | 7.6, 99 | 5.5, 149 | 149 (32) |
| Qwen/Qwen3.8-27B | dicht, 27B | BF16 | 52 GB | 4,4, 0,91 s | 3.7, 50 | 3.1, 50 | 50 (16 und 32) |
| Qwen/Qwen3.8-27B-FP8 | dicht, 27B | FP8 | 29 GB | 7,7, 0,60 s | 6.2, 74 | 5.0, 154 | 154 (32) |
| Inferact/Qwen3.8-27B-NVFP4 | dicht, 27B | NVFP4 | 25 GB | 9,5, 0,58 s | 7.2, 99 | 5.5, 149 | 149 (32) |
| unsloth/Qwen3.8-27B-NVFP4 | dicht, 27B | NVFP4 | 22 GB | 11,0, 0,52 s | 7.9, 102 | 6.0, 149 | 149 (32) |
Die Tokens pro Sekunde pro Anfrage geben an, wie schnell eine Antwortströme entstehen; die Gesamtzahl ist die Anzahl der ausgegebenen Tokens aller innerhalb des Messfensters abgeschlossenen Anfragen geteilt durch die Länge des Messfensters. TTFT ist die mittlere Zeit bis zum ersten Token. Size ist die Größe des Repositoriums des Modells bei Hugging Face. “Active” ist die Anzahl der Parameter, die ein Expertengemisch (MoE) für jeden generierten Token verwendet, geteilt durch die Gesamtzahl dieser Parameter.
Im Folgenden werfe ich einen Blick auf eine Auswahl der Modellfamilien, die ich getestet habe, um Ihnen weitere Details zu liefern.
Gemma 4
Die drei Gemma-Modelle umfassen zwei ganz unterschiedliche Designs. gemma-4-E4B-it ist ein kleines, dichtes Modell, und die QAT-Variante ist das gleiche Modell, das trainiert wurde, mit 4-Bit-Gewichten zu arbeiten. gemma-4-26B-A4B-it ist ein Hybrid-Modell mit 26 Milliarden Parametern, von denen etwa 4 Milliarden pro Token verwendet werden.
Die QAT-Variante erreichte bei allen 14 Modellen auf dem Spark die höchste Gesamtzuführung: 1.075 Tokens pro Sekunde bei 32 gleichzeitigen Anfragen. Eine einzelne Anfrage floss mit etwa 51 Tokens pro Sekunde, und bei 16 gleichzeitigen Anfragen flossen jeweils noch etwa 43 Tokens. Die BF16-Version desselben Modells war pro Anfrage langsamer, zwischen etwa 18 und 22 Tokens pro Sekunde, behielt diese Geschwindigkeit jedoch fast unverändert von 1 bis 32 gleichzeitigen Anfragen bei, während ihre Gesamtzuführung bei 569 anstieg.
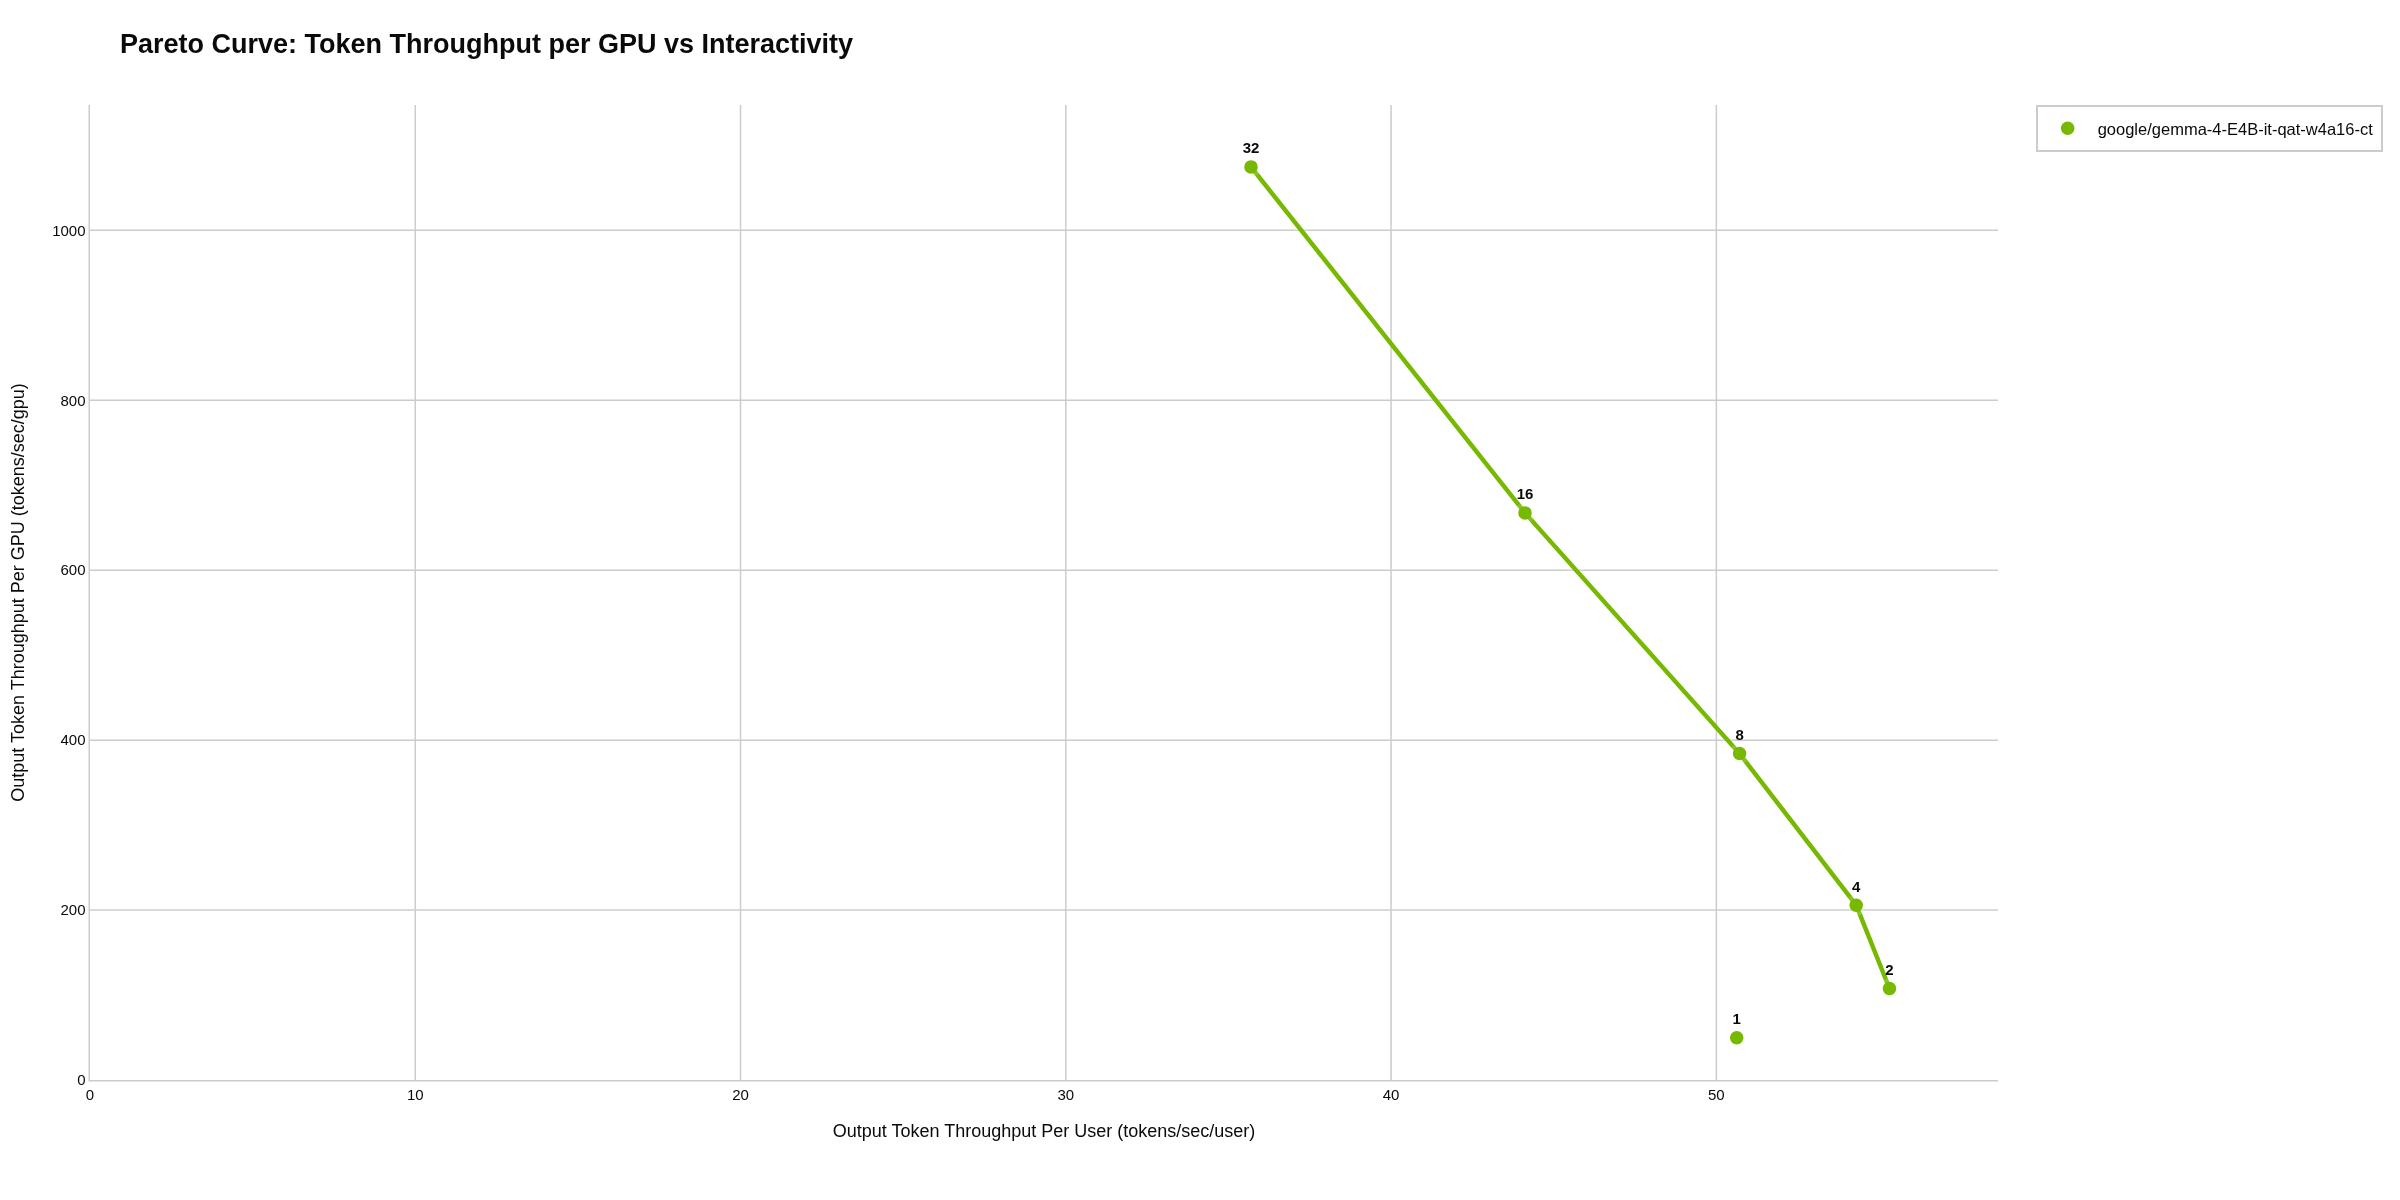
google/gemma-4-E4B-it-qat-w4a16-ct auf dem DGX Spark.
Ein Detail in diesem Diagramm: Der Punkt für eine gleichzeitige Anforderung liegt außerhalb der Linie, etwas links von dem Punkt für zwei. Eine einzelne Anforderung führte etwas langsamer (etwa 51 Tokens pro Sekunde) als jede der beiden simultanen Anfragen (etwa 55) über. Die BF16-Version zeigt das gleiche Muster. Da Spark nur eine einzelne Ausführung pro Ladevorgang unterstützt, kann ich nicht sagen, ob dies ein Rauschen oder eine Eigenschaft der Konfiguration ist.
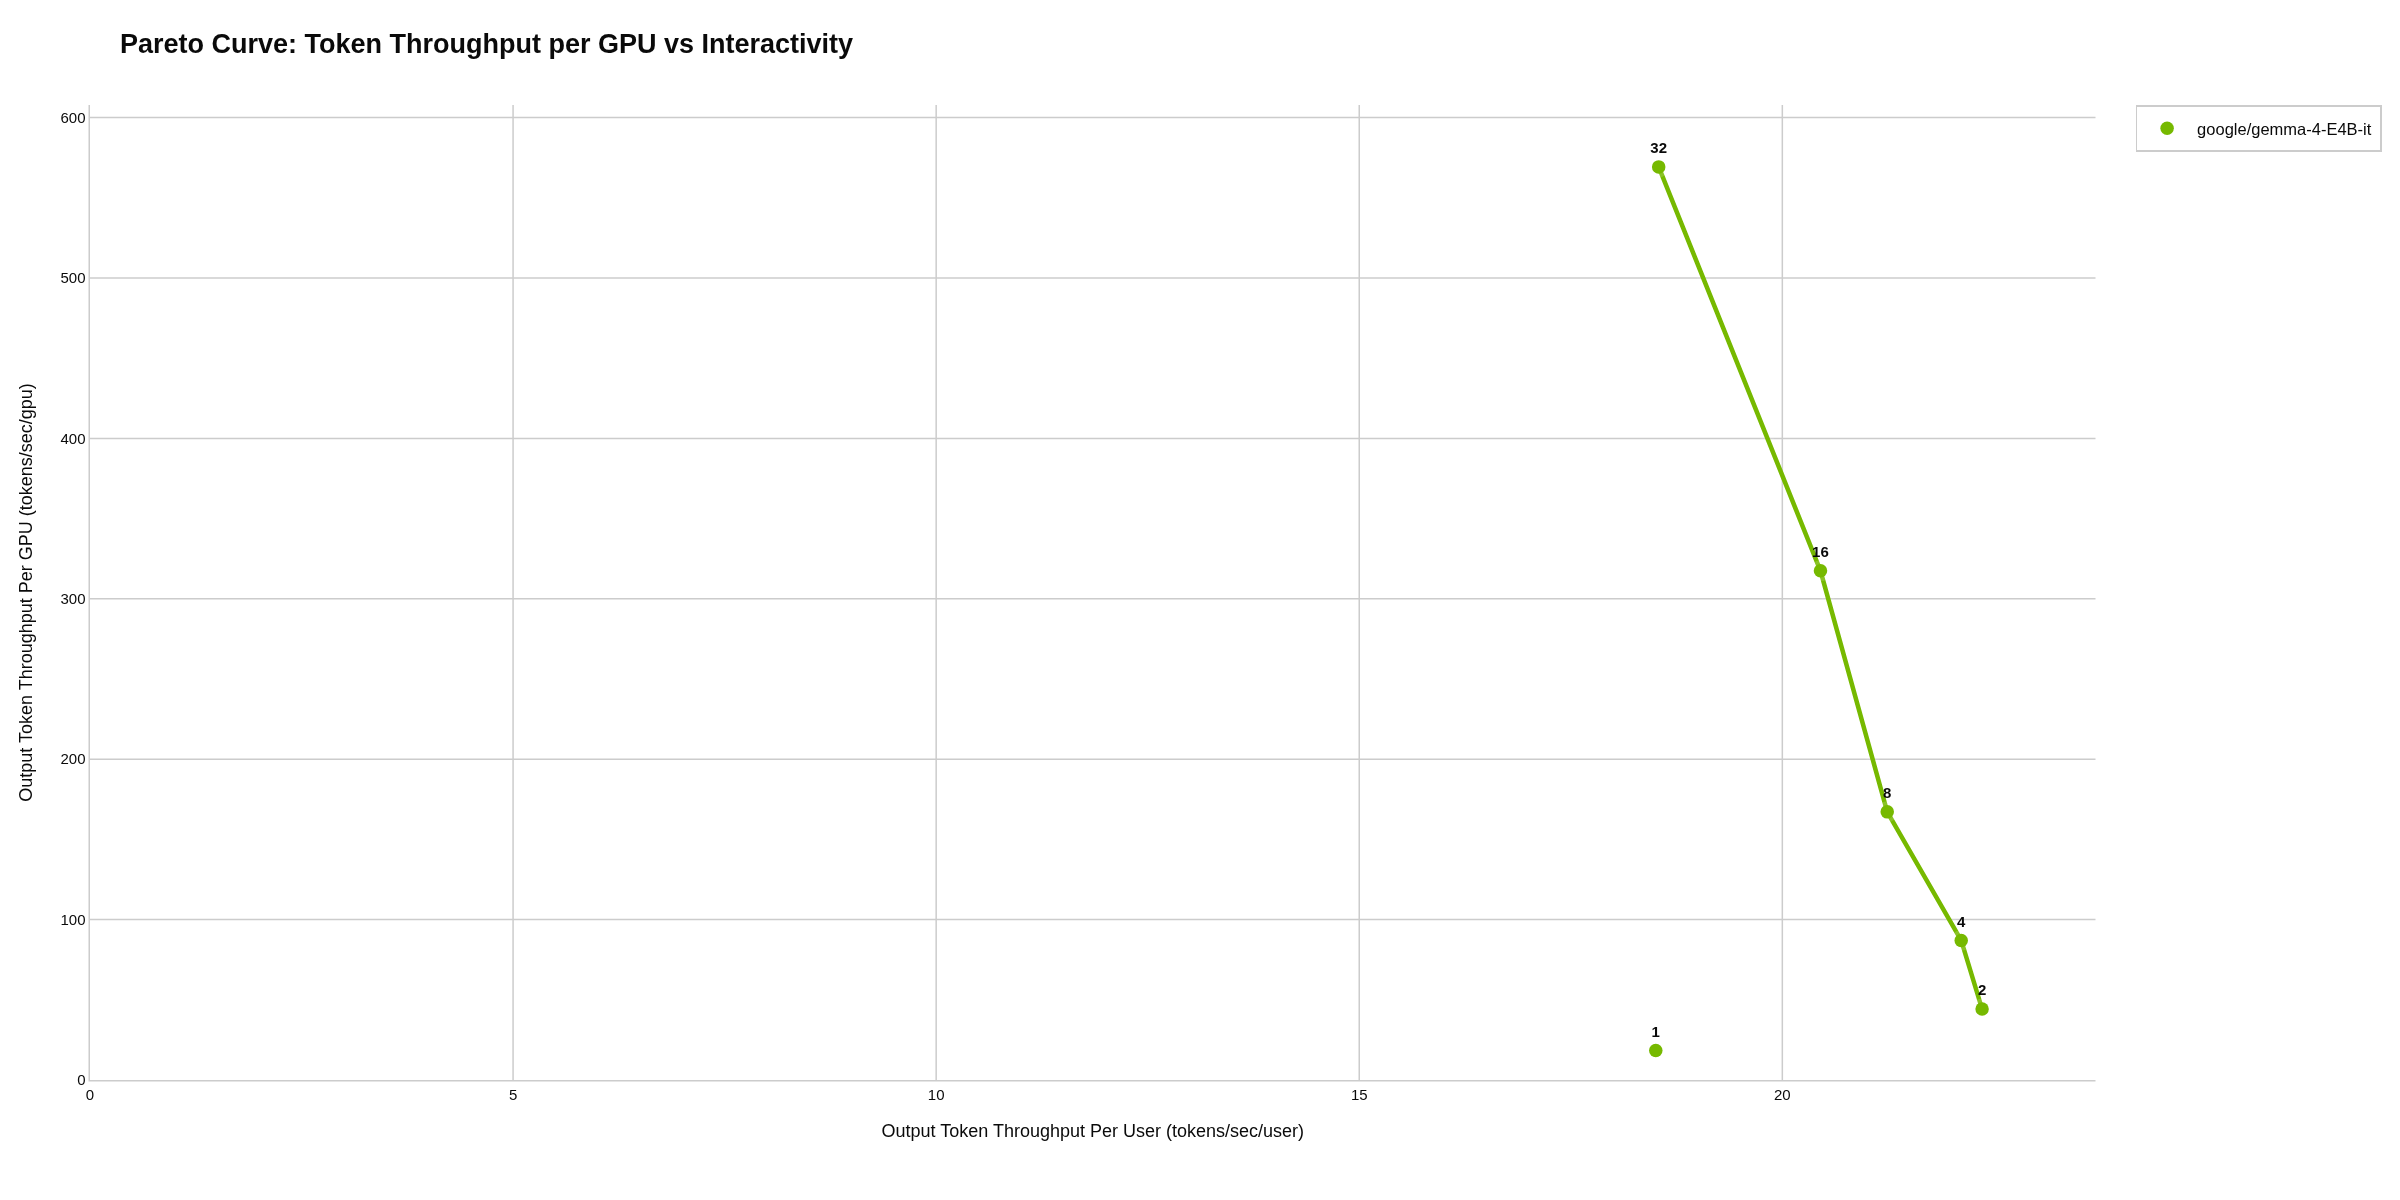
google/gemma-4-E4B-it auf dem DGX Spark.
gemma-4-26B-A4B-Die Geschwindigkeit begann bei etwa 23 Token pro Sekunde für eine einzelne Anforderung und erreichte insgesamt 199 bei 32 gleichzeitig stattfindenden Anfragen, wobei jede Antwort mit etwa 7 Token pro Sekunde flossen.
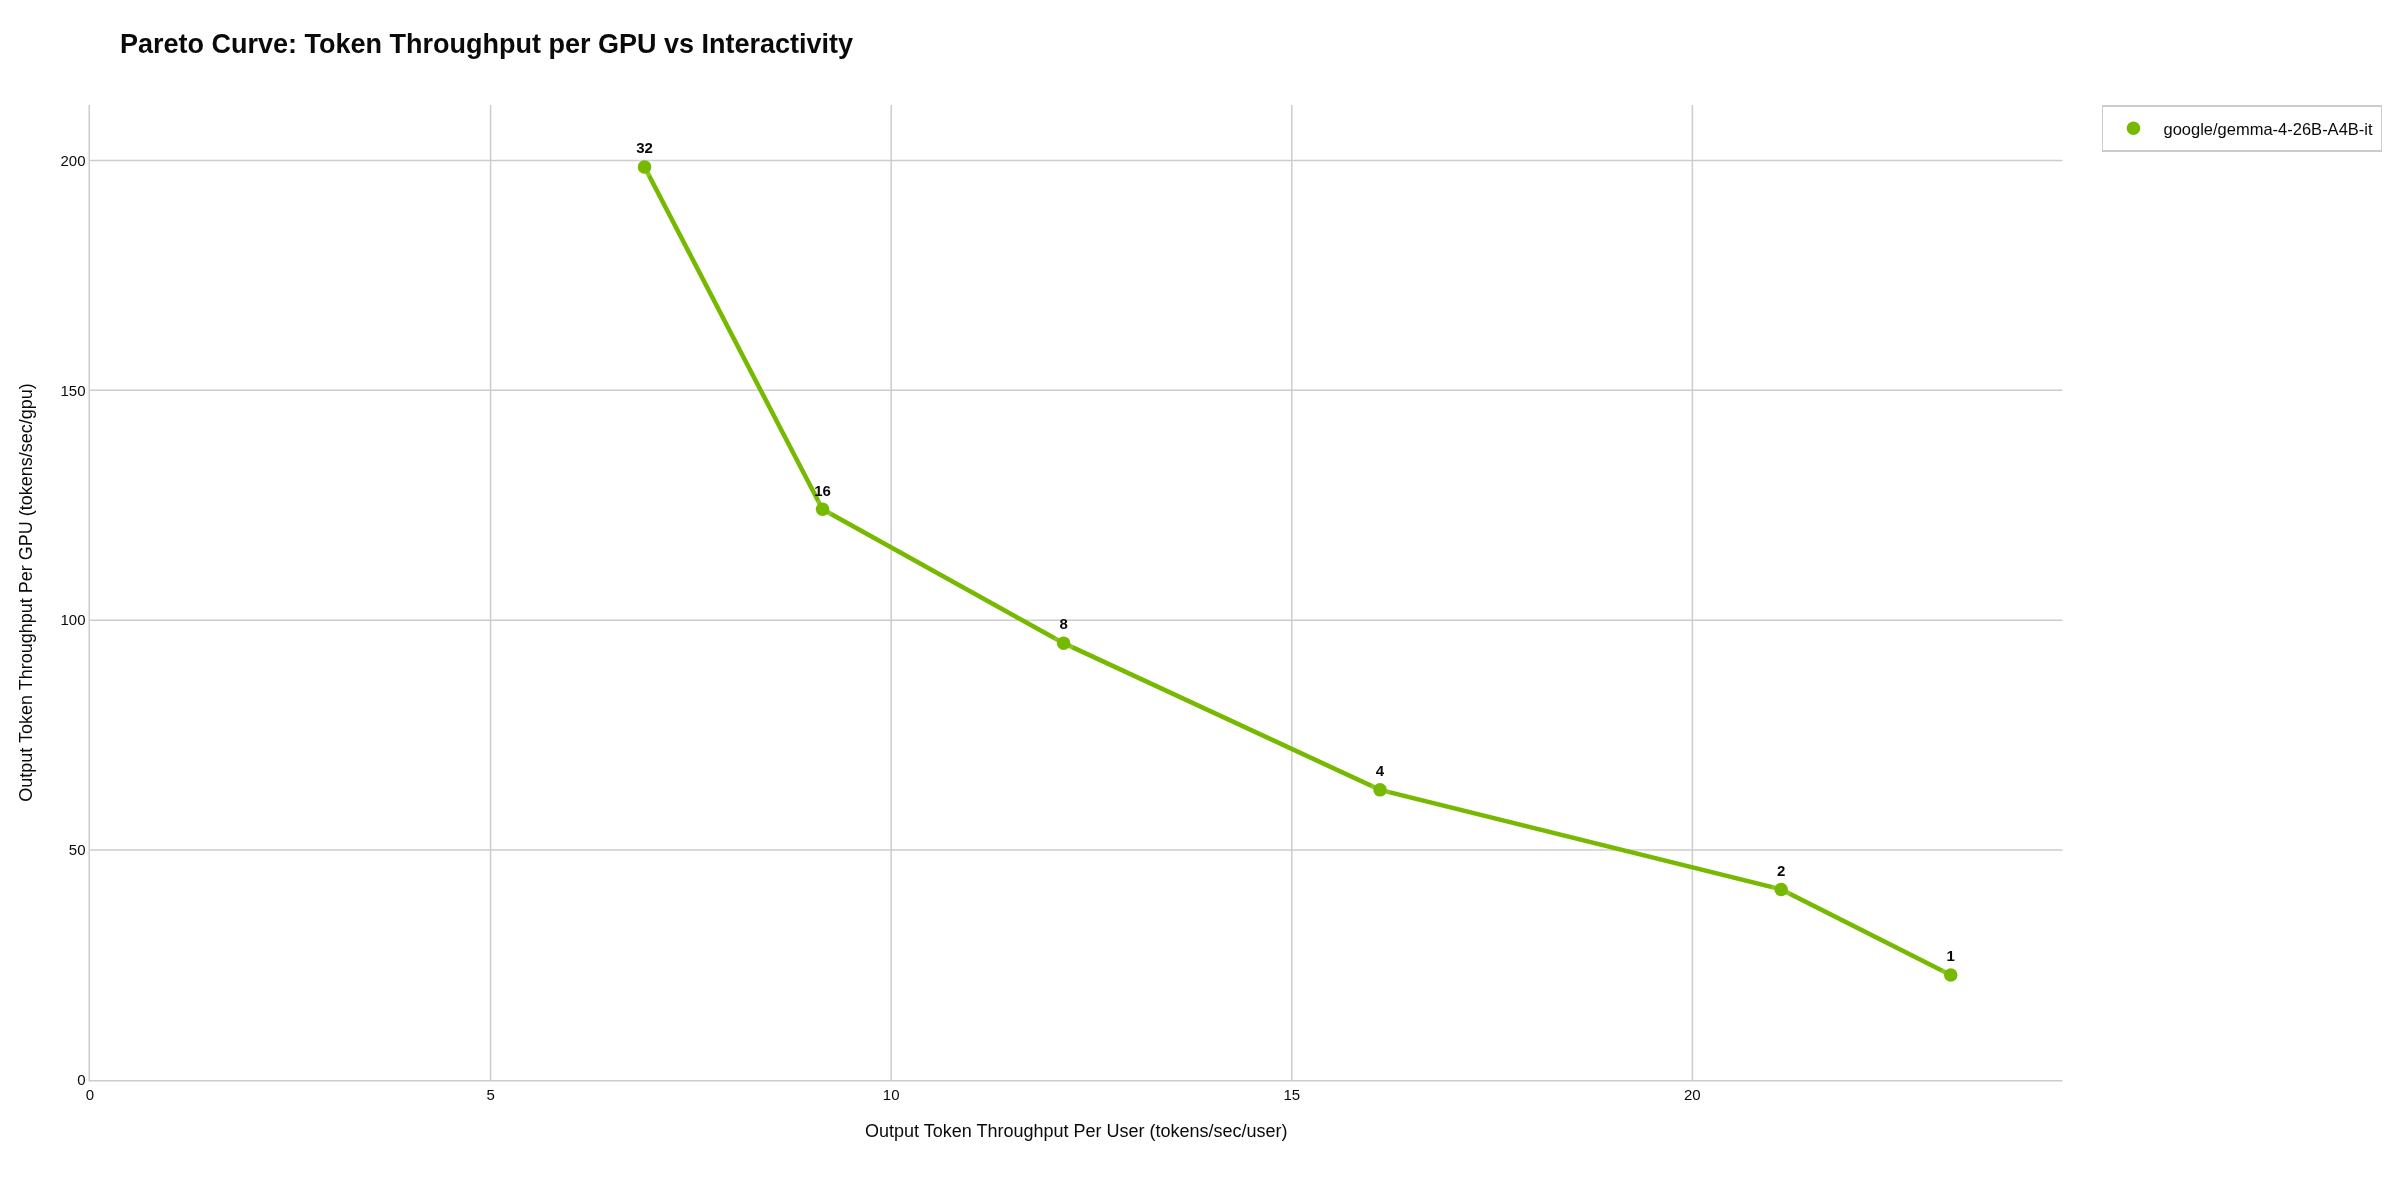
google/gemma-4-26B-A4B-it auf dem DGX Spark.
Nemotron
nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4, das Modell im obigen Beispieldiagramm, ist ein Modell mit einem Mischungsverhältnis von Experten mit etwa 3 Milliarden aktiven Parametern, das in NVFP4 gespeichert ist, dem Vierbit-Format von NVIDIA für die Blackwell-GPUs. Es lieferte eine einzige Antwort mit einer Geschwindigkeit von etwa 70 Token pro Sekunde, der zweithöchsten Einzelanforderungsschnittstelle in diesem Test, und erreichte insgesamt 452 Token pro Sekunde bei 32 gleichzeitig gesendeten Anfragen.
nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4 ist das größte Modell in diesem Test: 120 Milliarden Parameter, davon 12 Milliarden aktiv pro Token. Auf dem Spark generierte es pro Anfrage etwa 16 Tokens und insgesamt 80 bei 16 gleichzeitig laufenden Anfragen – das höchste Niveau, das ich für dieses Modell getestet habe.
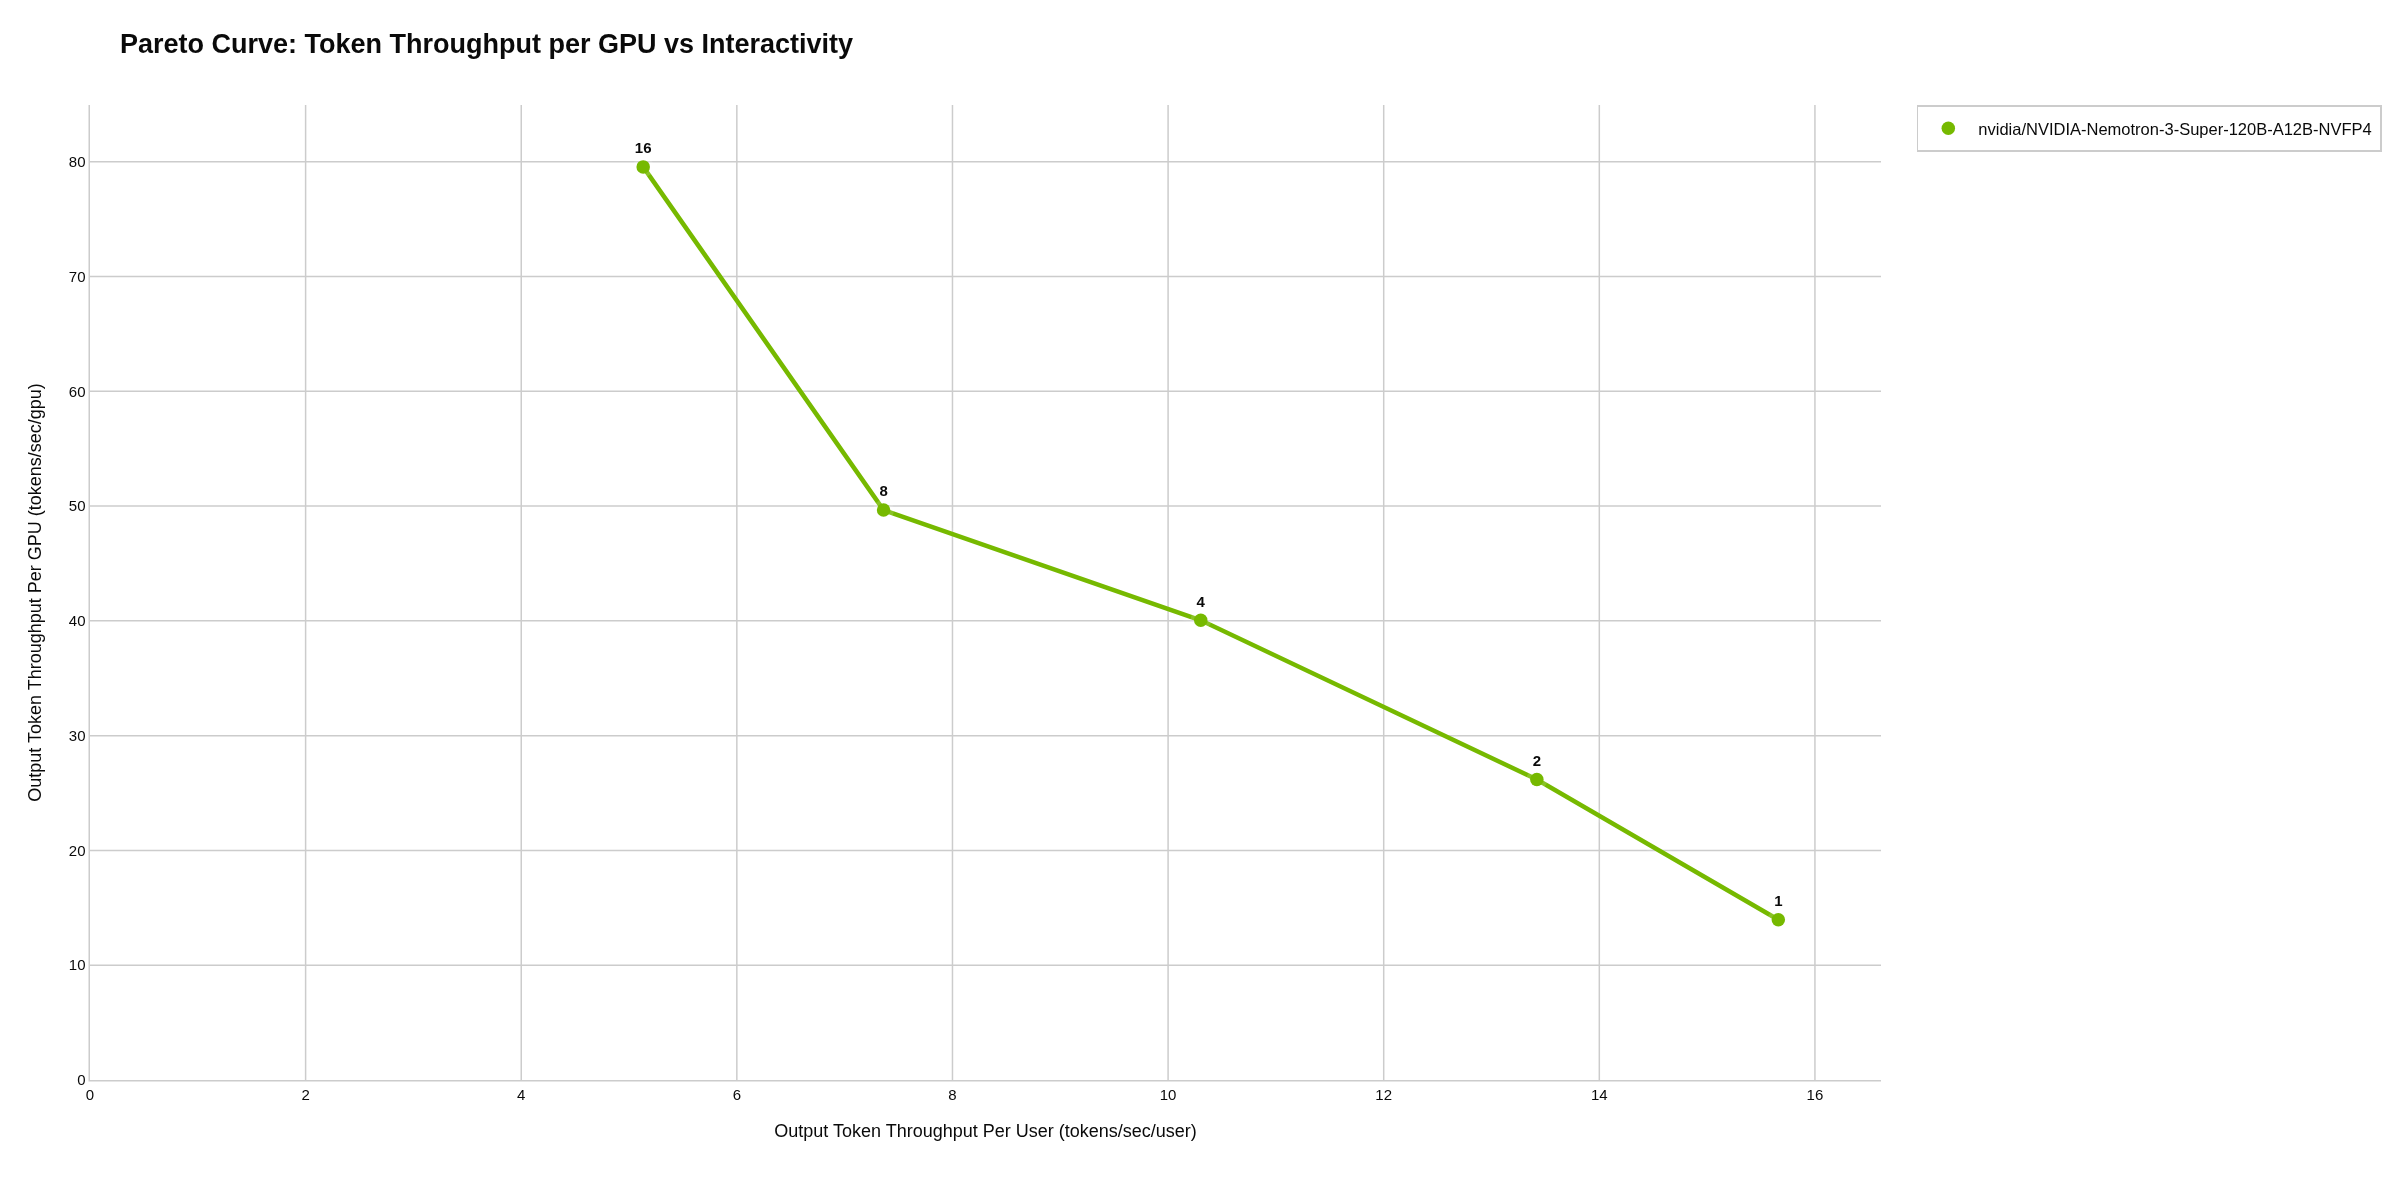
nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4 auf dem DGX Spark. Testet bis zu 16 gleichzeitige Anfragen.
Granit
ibm-granite/granite-4.2-30b ist ein dichtes Modell mit 30 Milliarden Parametern in BF16. Jeder Token durchläuft alle seine Parameter, etwa 55 GB an Gewichtungen. Es generierte pro Anfrage etwa 4 Token. AIPerf meldet eine Gesamtzahl von 50 Token pro Sekunde bei beiden 16- und 32-parallelen Anfragen. Das eigene Token-Counter von vLLM, das AIPerf zusammen mit dem verzeichnete, zeigt eine zunehmende Generierung von etwa 51 auf etwa 96. Bei 32 verlangten jeweils etwa drei Minuten, und AIPerf zählt nur Anfragen, die innerhalb des Messbereichs abgeschlossen werden. Die durchschnittliche Zeit bis zum ersten Token bei 32 stieg auf etwa 14 Sekunden. Die dichten Qwen-Modelle in BF16 unten zeigen das gleiche Muster.
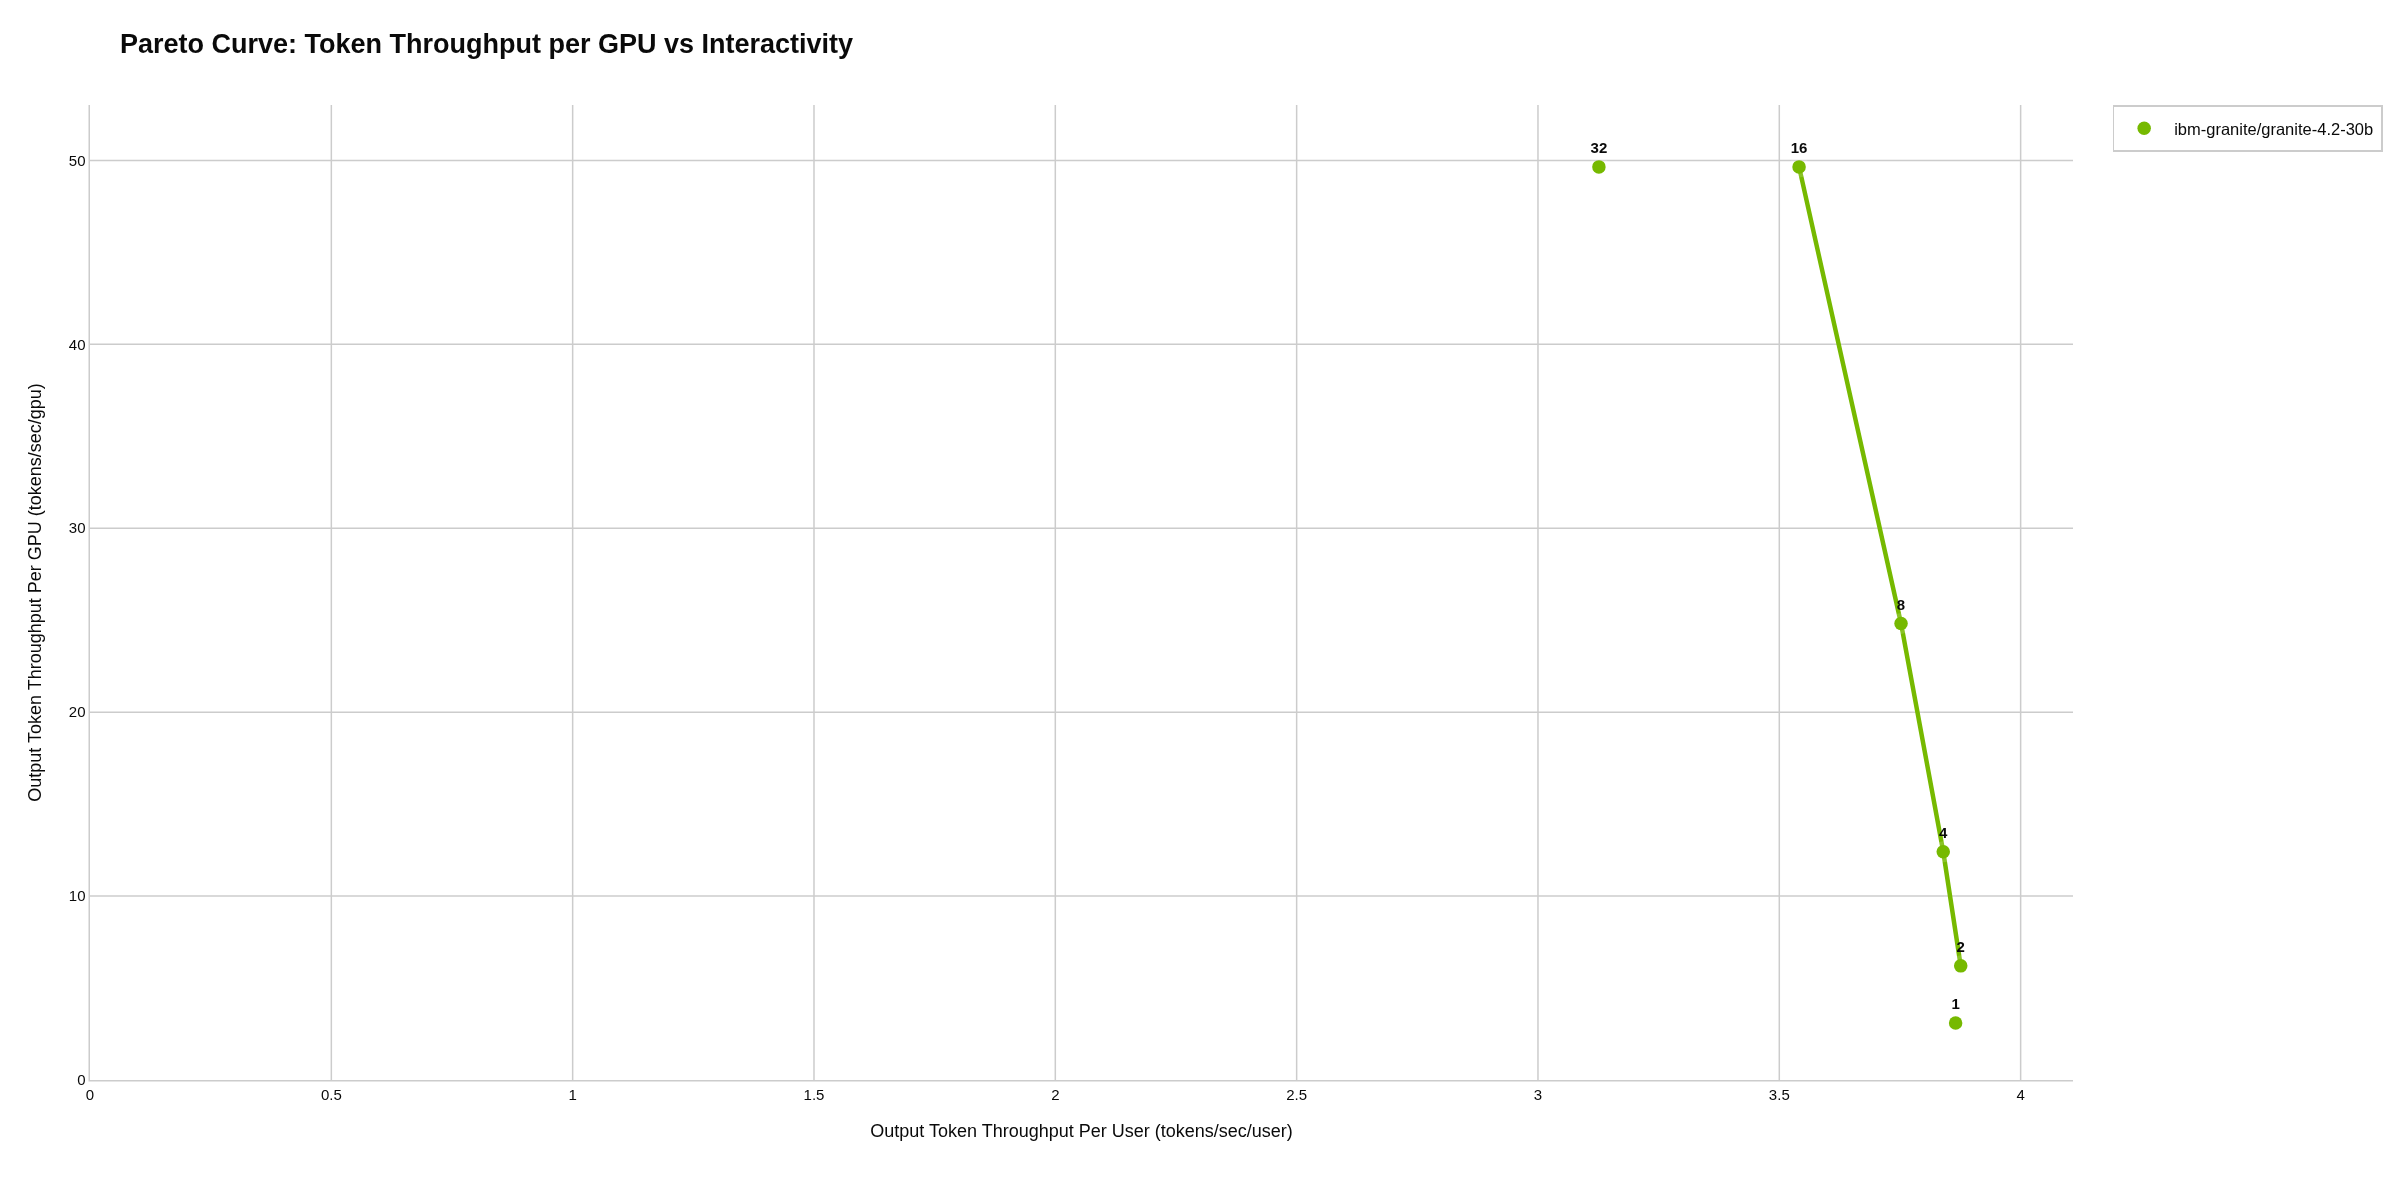
ibm-granite/granite-4.2-30b auf dem DGX Spark. Die Punktzahl für 16 und 32 gleichzeitige Anfragen liegt bei etwa gleicher Gesamtdurchsatzleistung.
Qwen
Die Qwen-Gruppe besteht aus zwei Teilen: dem Expertensystem Qwen3.6-35B-A3B und zwei dichten Modellen mit 27 Milliarden Parametern, Qwen3.6-27B und Qwen3.8-27B. Ich habe mehrere davon unter mehr als einer Präzision getestet.
Qwen3.6-35B-A3B verwendet etwa 3 Milliarden seiner 35 Milliarden Parameter pro Token. In BF16 generierte es pro Anfrage etwa 30 Token und insgesamt 204 bei 32 gleichzeitig laufenden Anfragen. Die NVFP4-Version des gleichen Modells von NVIDIA erreichte für eine einzelne Anfrage etwa 76 Token pro Sekunde, die höchste Einzelanfragegeschwindigkeit in diesem Test und insgesamt 462 bei 32.
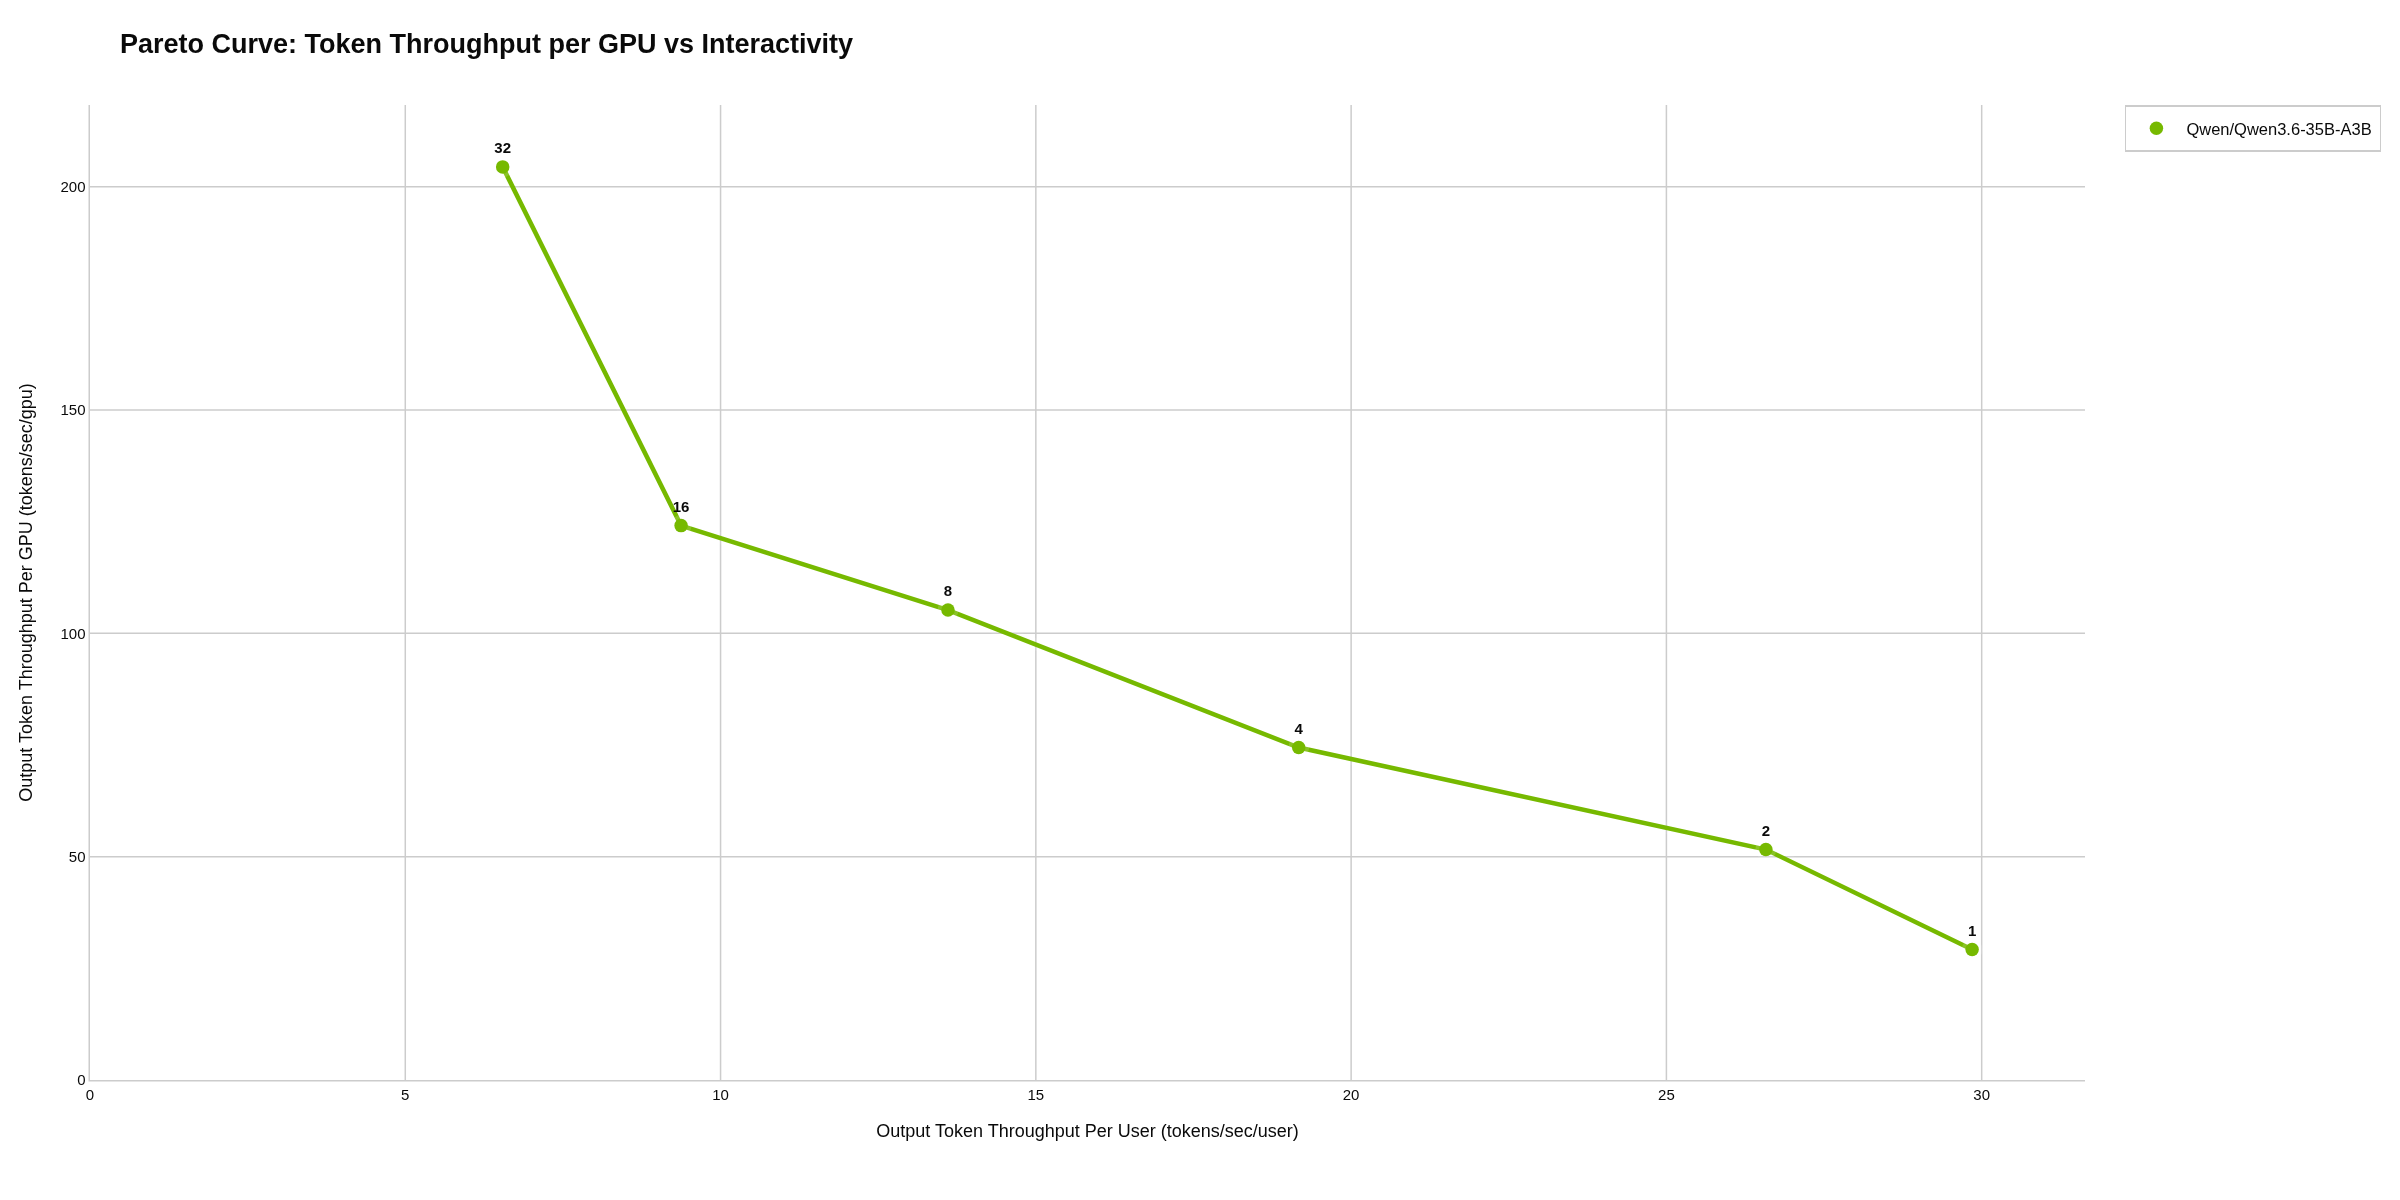
Qwen/Qwen3.6-35B-A3B auf dem DGX Spark.
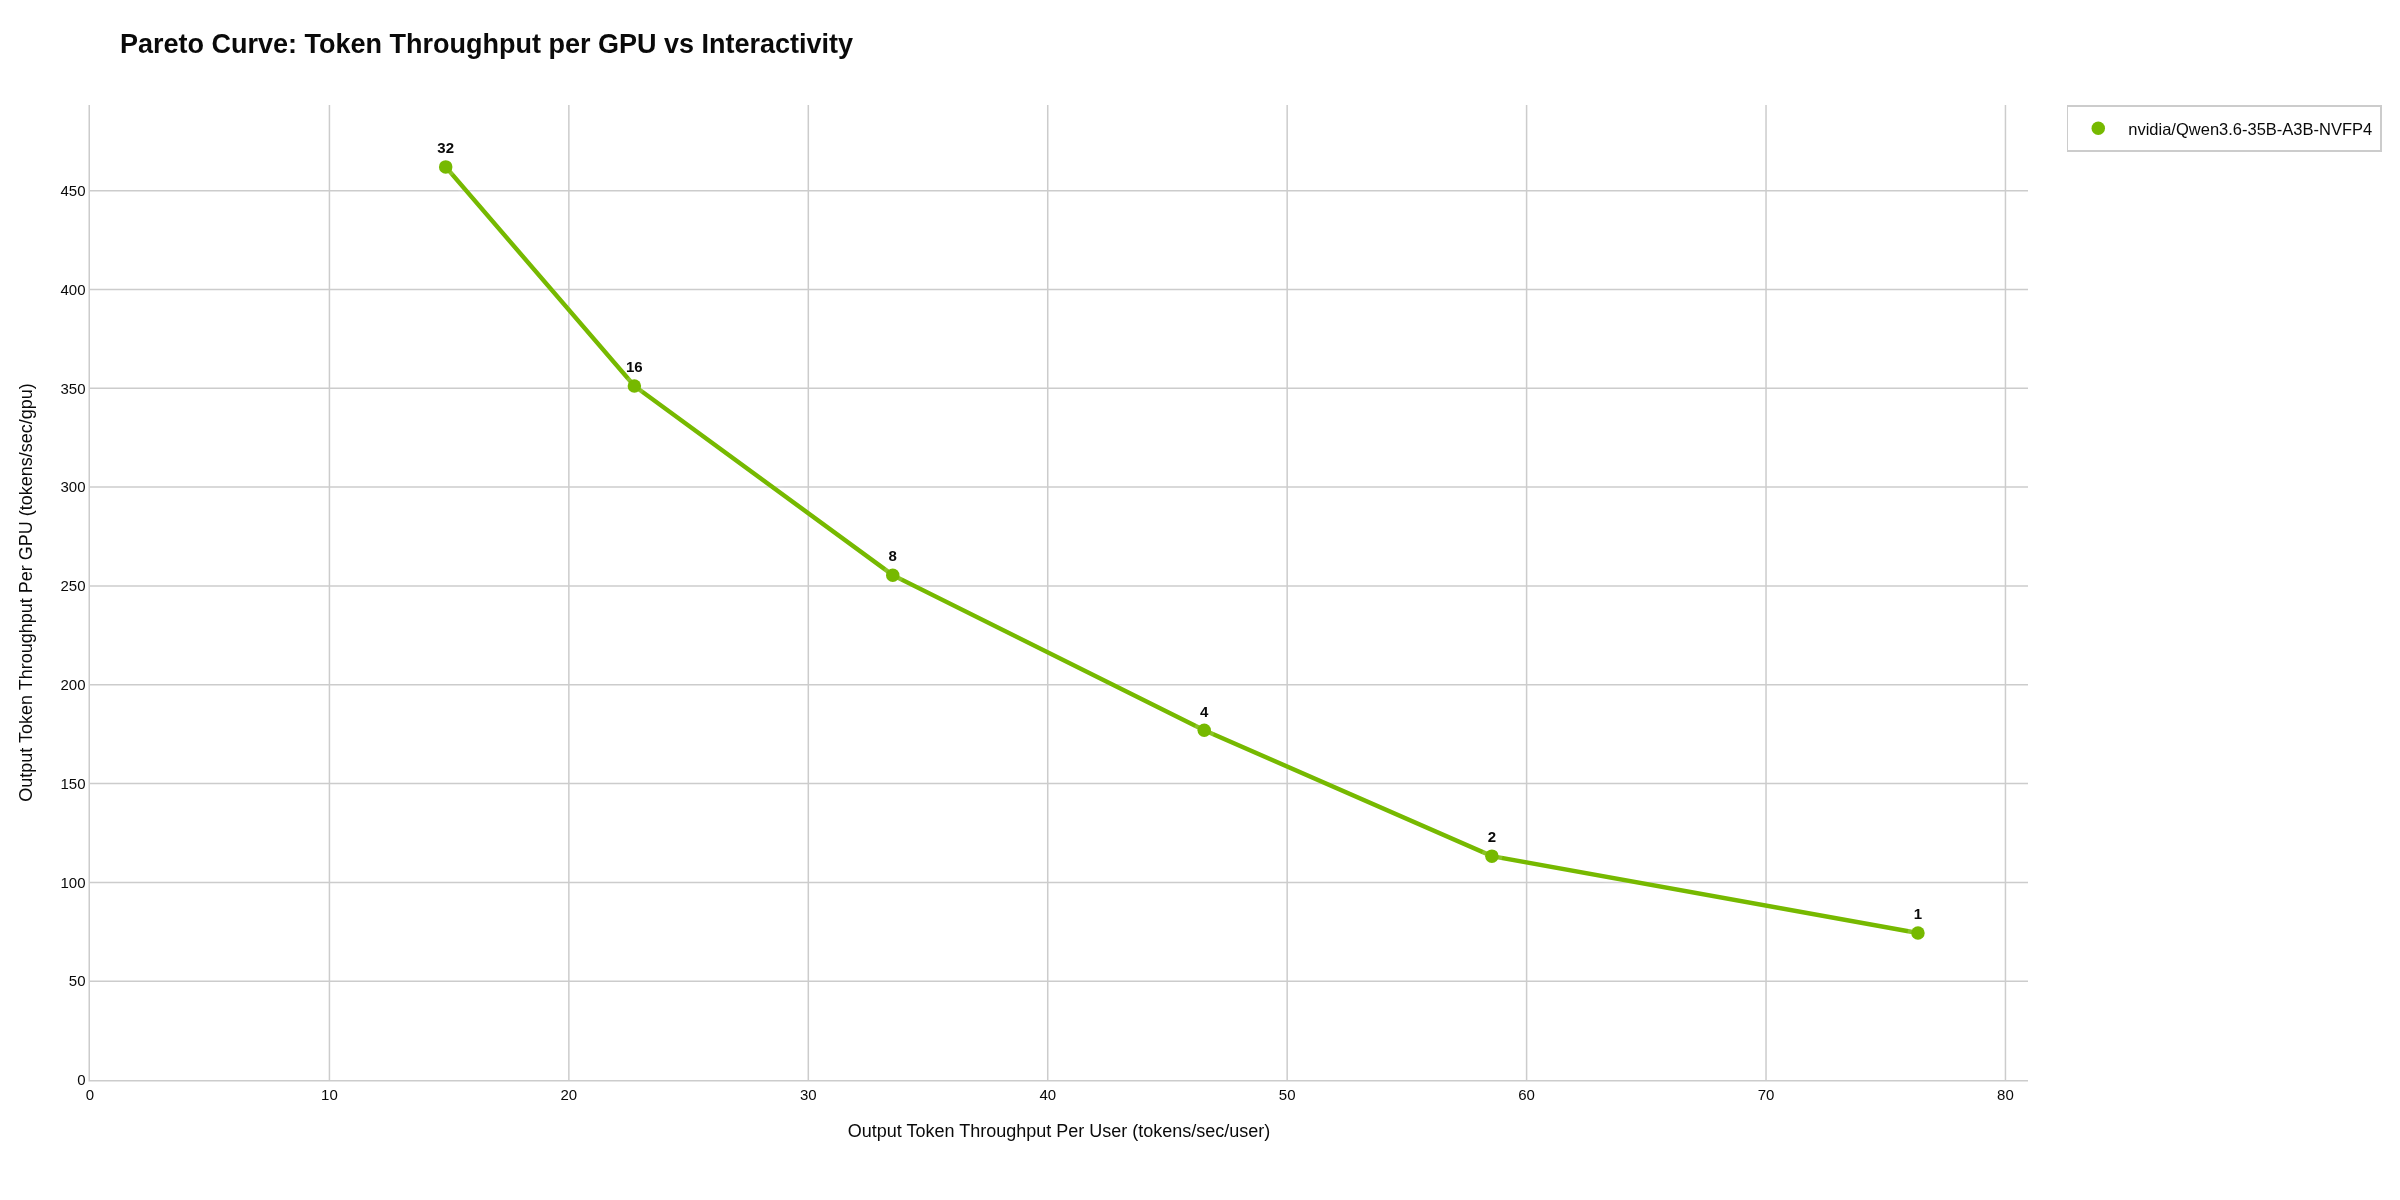
nvidia/Qwen3.6-35B-A3B-NVFP4 auf dem DGX Spark.
Die dichten Modelle BF16 mit der Kennung 27B generierten für eine einzelne Anfrage etwa 4,4 Tokens pro Sekunde. Mit den FP8-Gewichten erreichte Qwen3.8-27B 7,7; die drei NVFP4-Versionen von NVIDIA, Inferact und unsloth erreichten Werte von 9,5 bis 12,0. Bei 32 gleichzeitig laufenden Anfragen lieferten die quantisierten Versionen dennoch jeweils 5,0 bis 6,0 Token pro Sekunde – gegenüber den Originalen von BF16, die 3,1 Token pro Sekunde lieferten.
Bei den Versionen von BF16 zeigen die Karten von AIPerf die Werte für 16 und 32 zusammen:
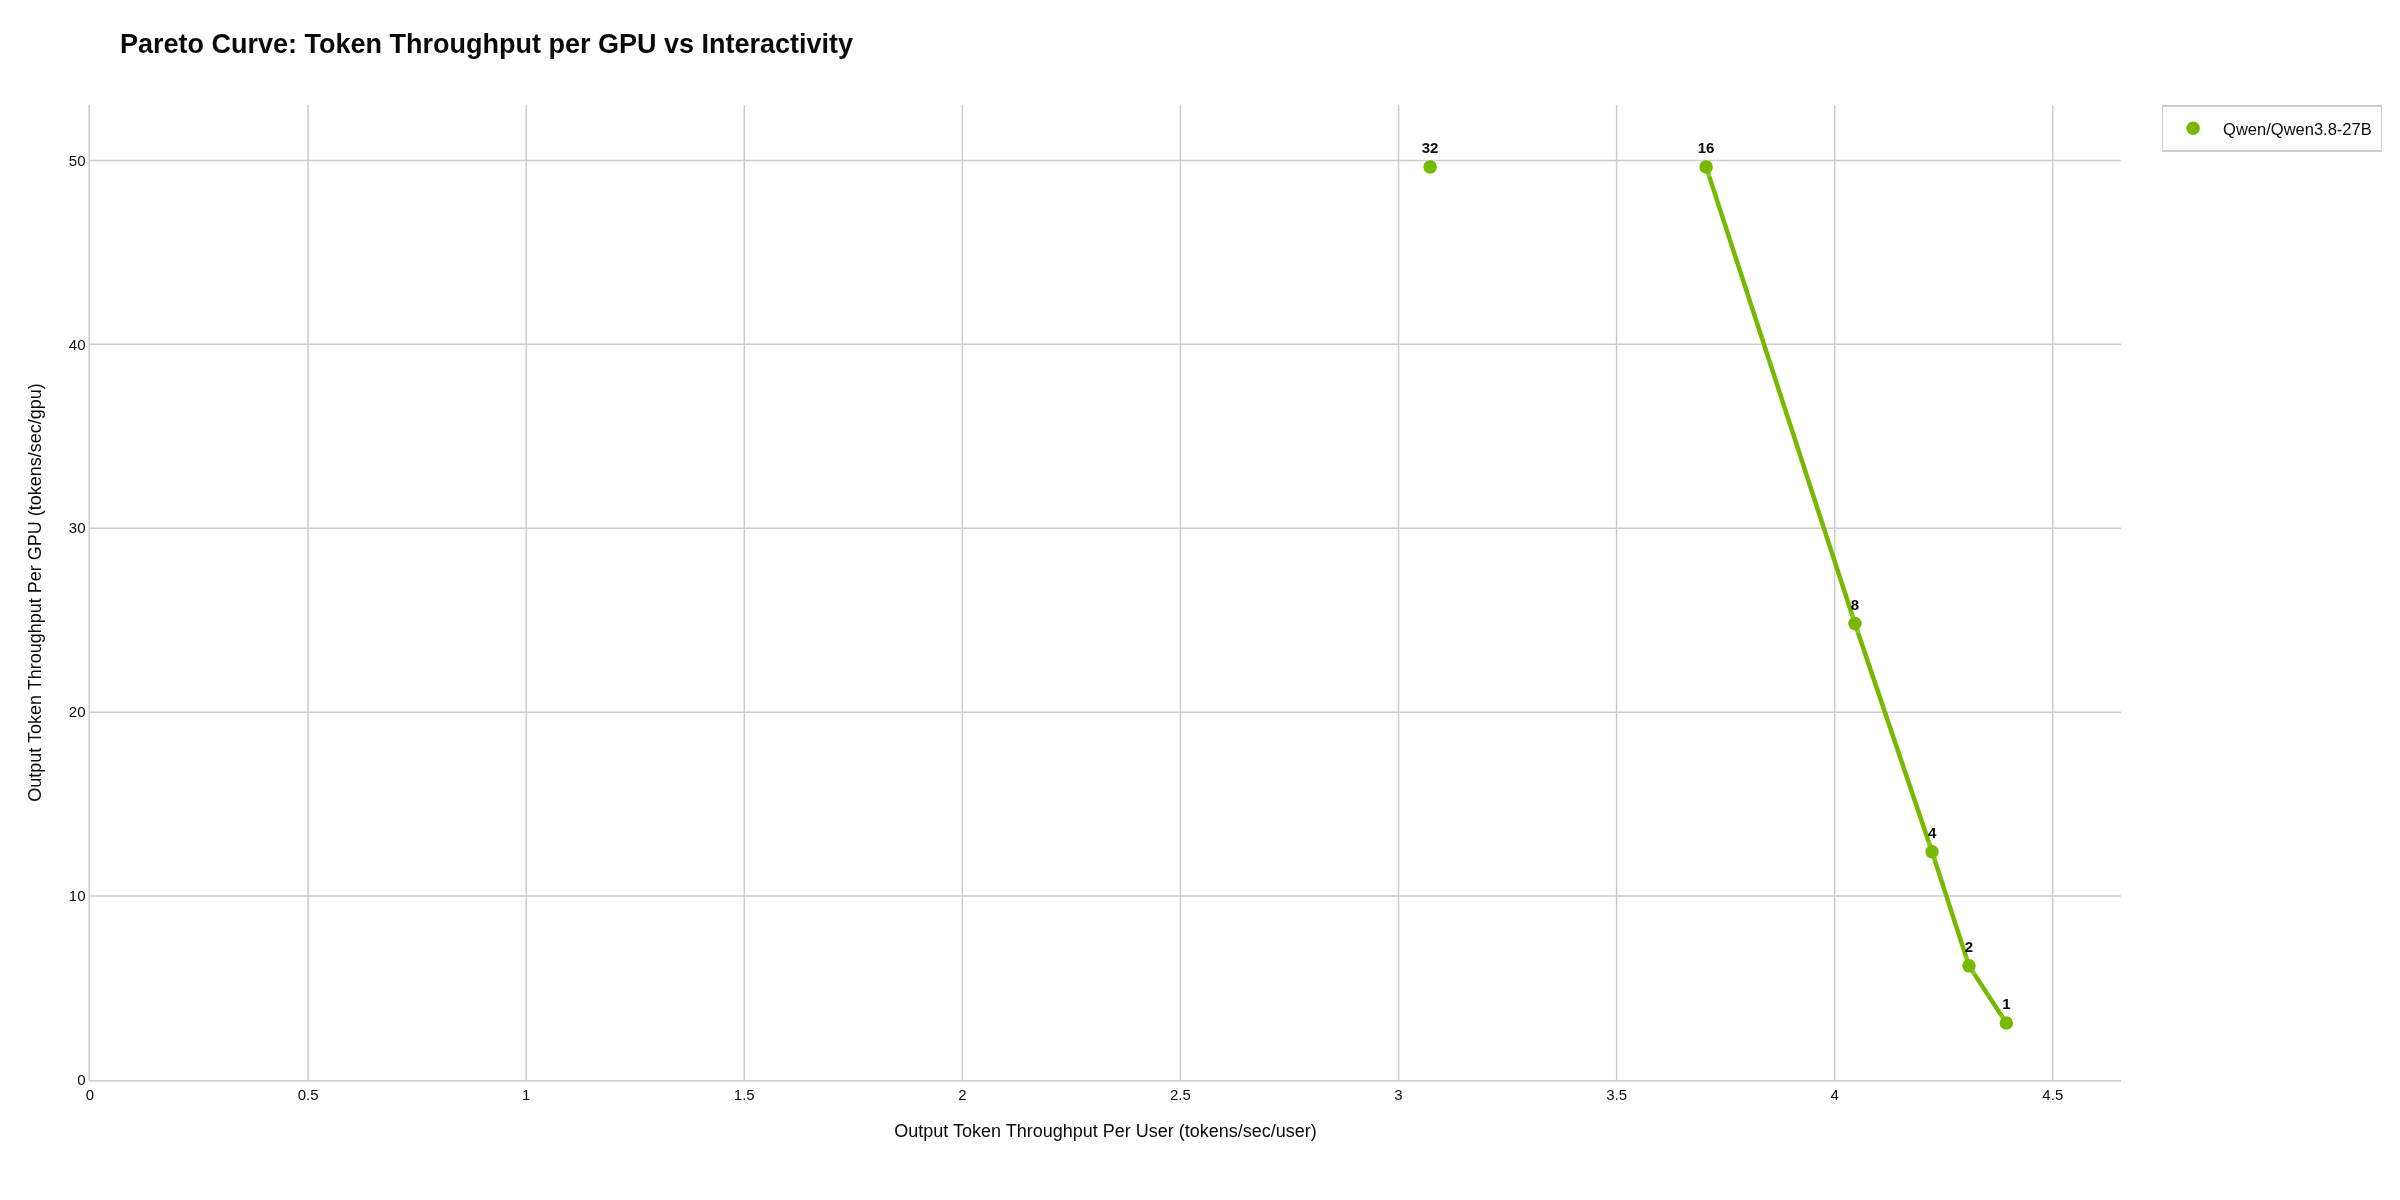
Qwen/Qwen3.8-27B (BF16) auf dem DGX Spark. Die Punkte für 16 und 32 gleichzeitige Anfragen entsprechen dem gleichen Gesamtdurchsatz.
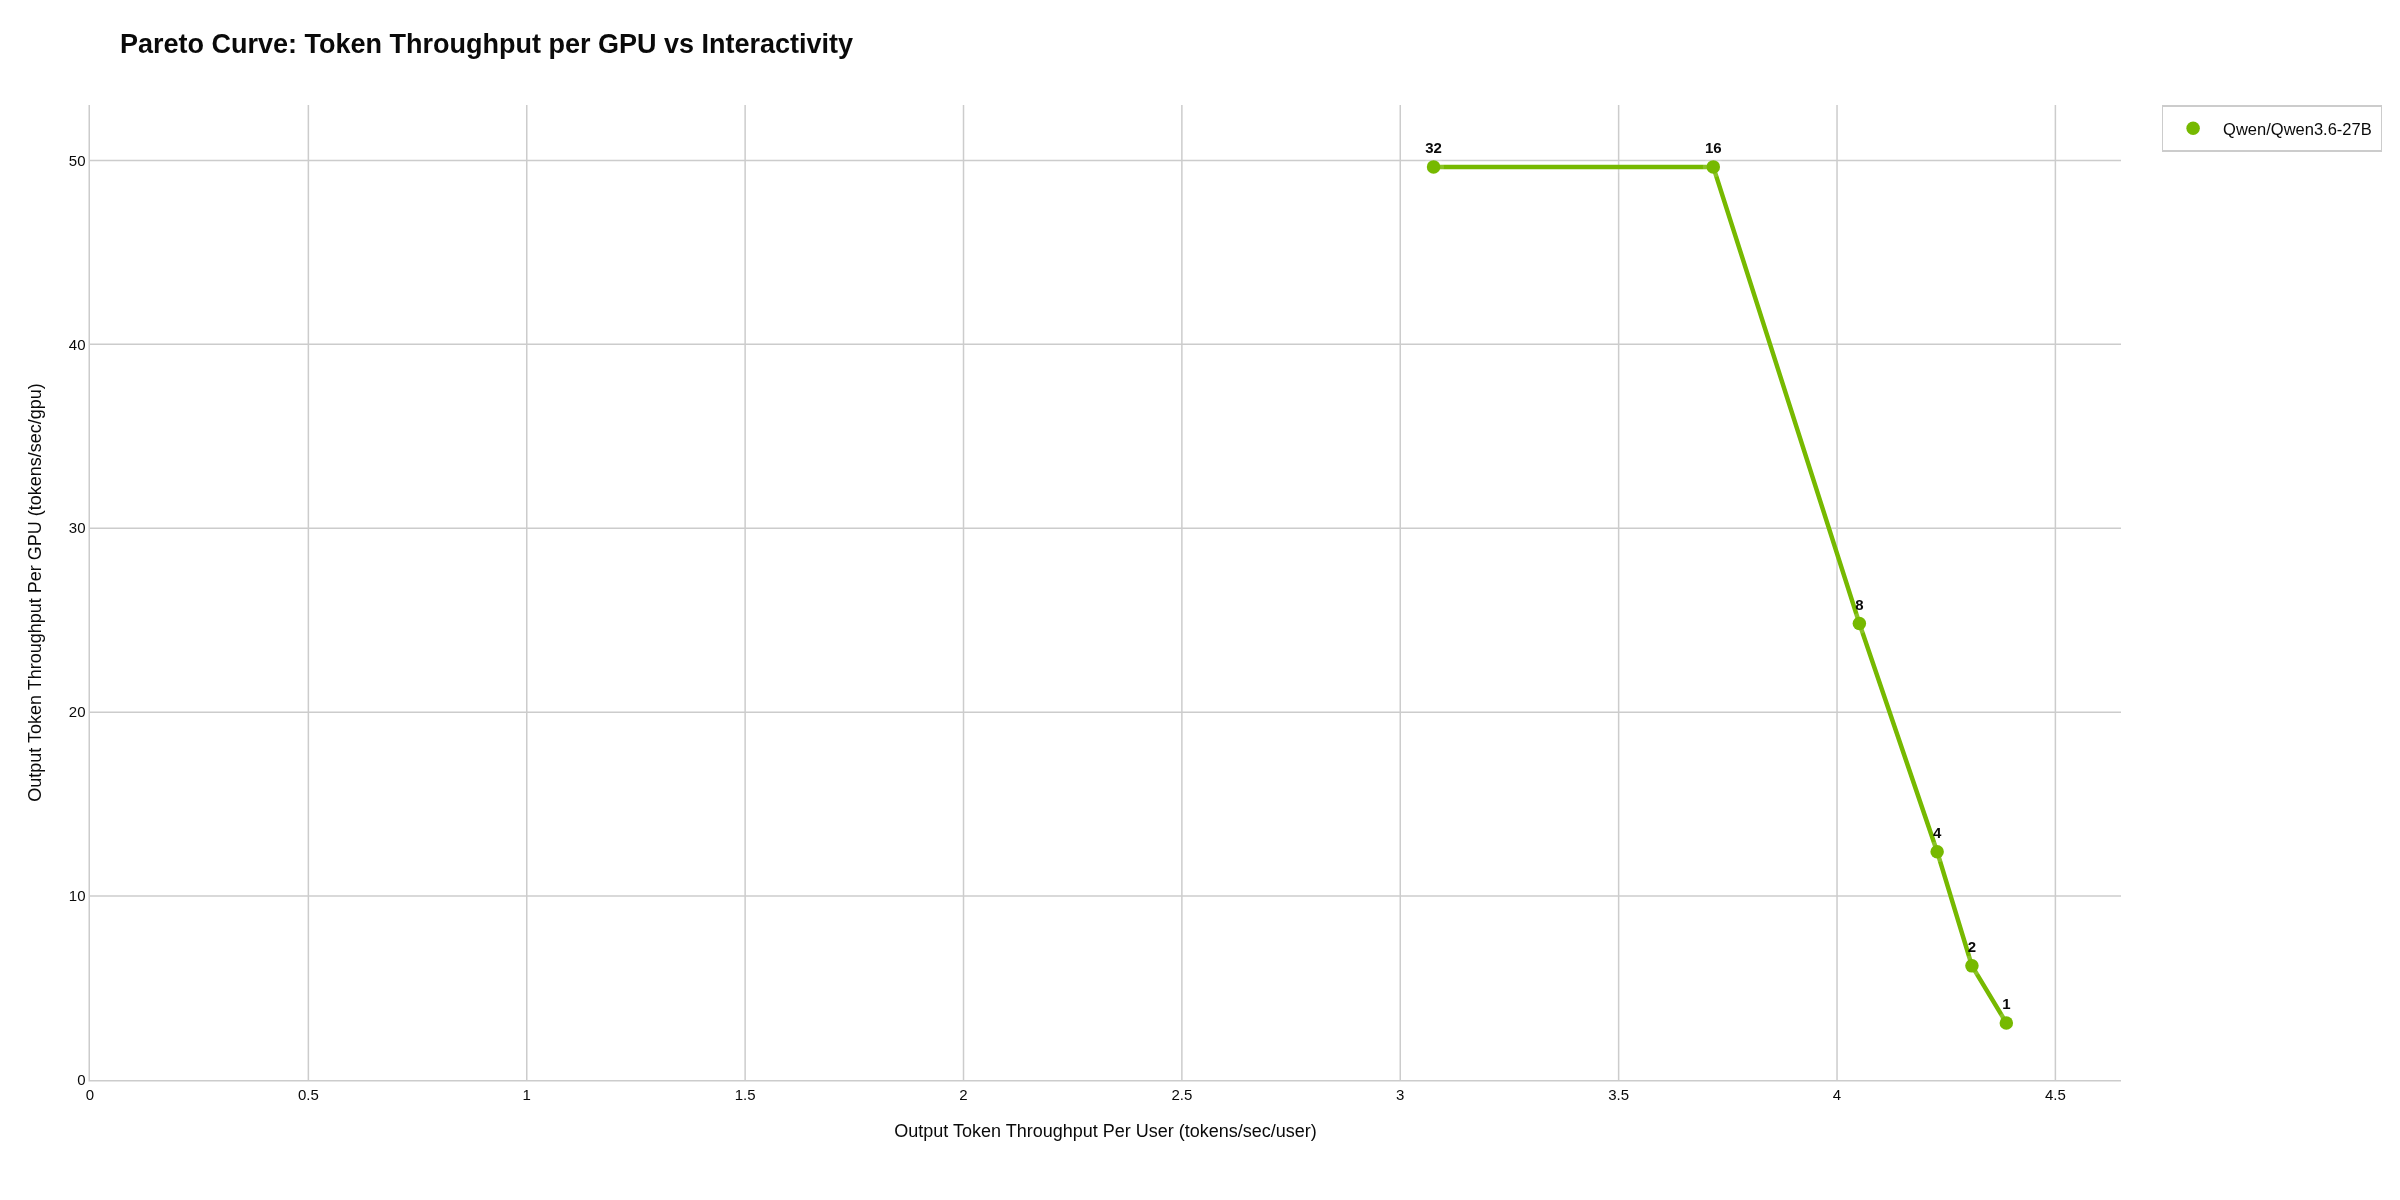
Qwen/Qwen3.6-27B auf dem DGX Spark. Die Punktzahl für 16 und 32 gleichzeitige Anfragen liegt bei etwa gleicher Gesamtdurchsatzleistung.
Bei einer Gesamtzahl von 16 bis 32 gleichzeitigen Anfragen lag die Gesamtzahl von AIPerf bei etwa 50 Tokens pro Sekunde, während der eigene Zähler von vLLM die Generation von etwa 57 auf etwa 95 erhöht. Die durchschnittliche Zeit bis zur ersten Token-Erzeugung erhöhte sich von etwa 5 auf etwa 14 Sekunden. Die Zeitlinie für die einzelnen Anfragen bei 32 zeigt dies: Die 32 Anfragen, die zusammen begonnen wurden, erhielten ihre erste Token-Erzeugung zwischen etwa 1 und 27 Sekunden nach ihrer Abgabe, jeweils nacheinander, und jeder benötigte anschließend etwa 2,5 Sekunden, um seine 512 Token zu generieren.
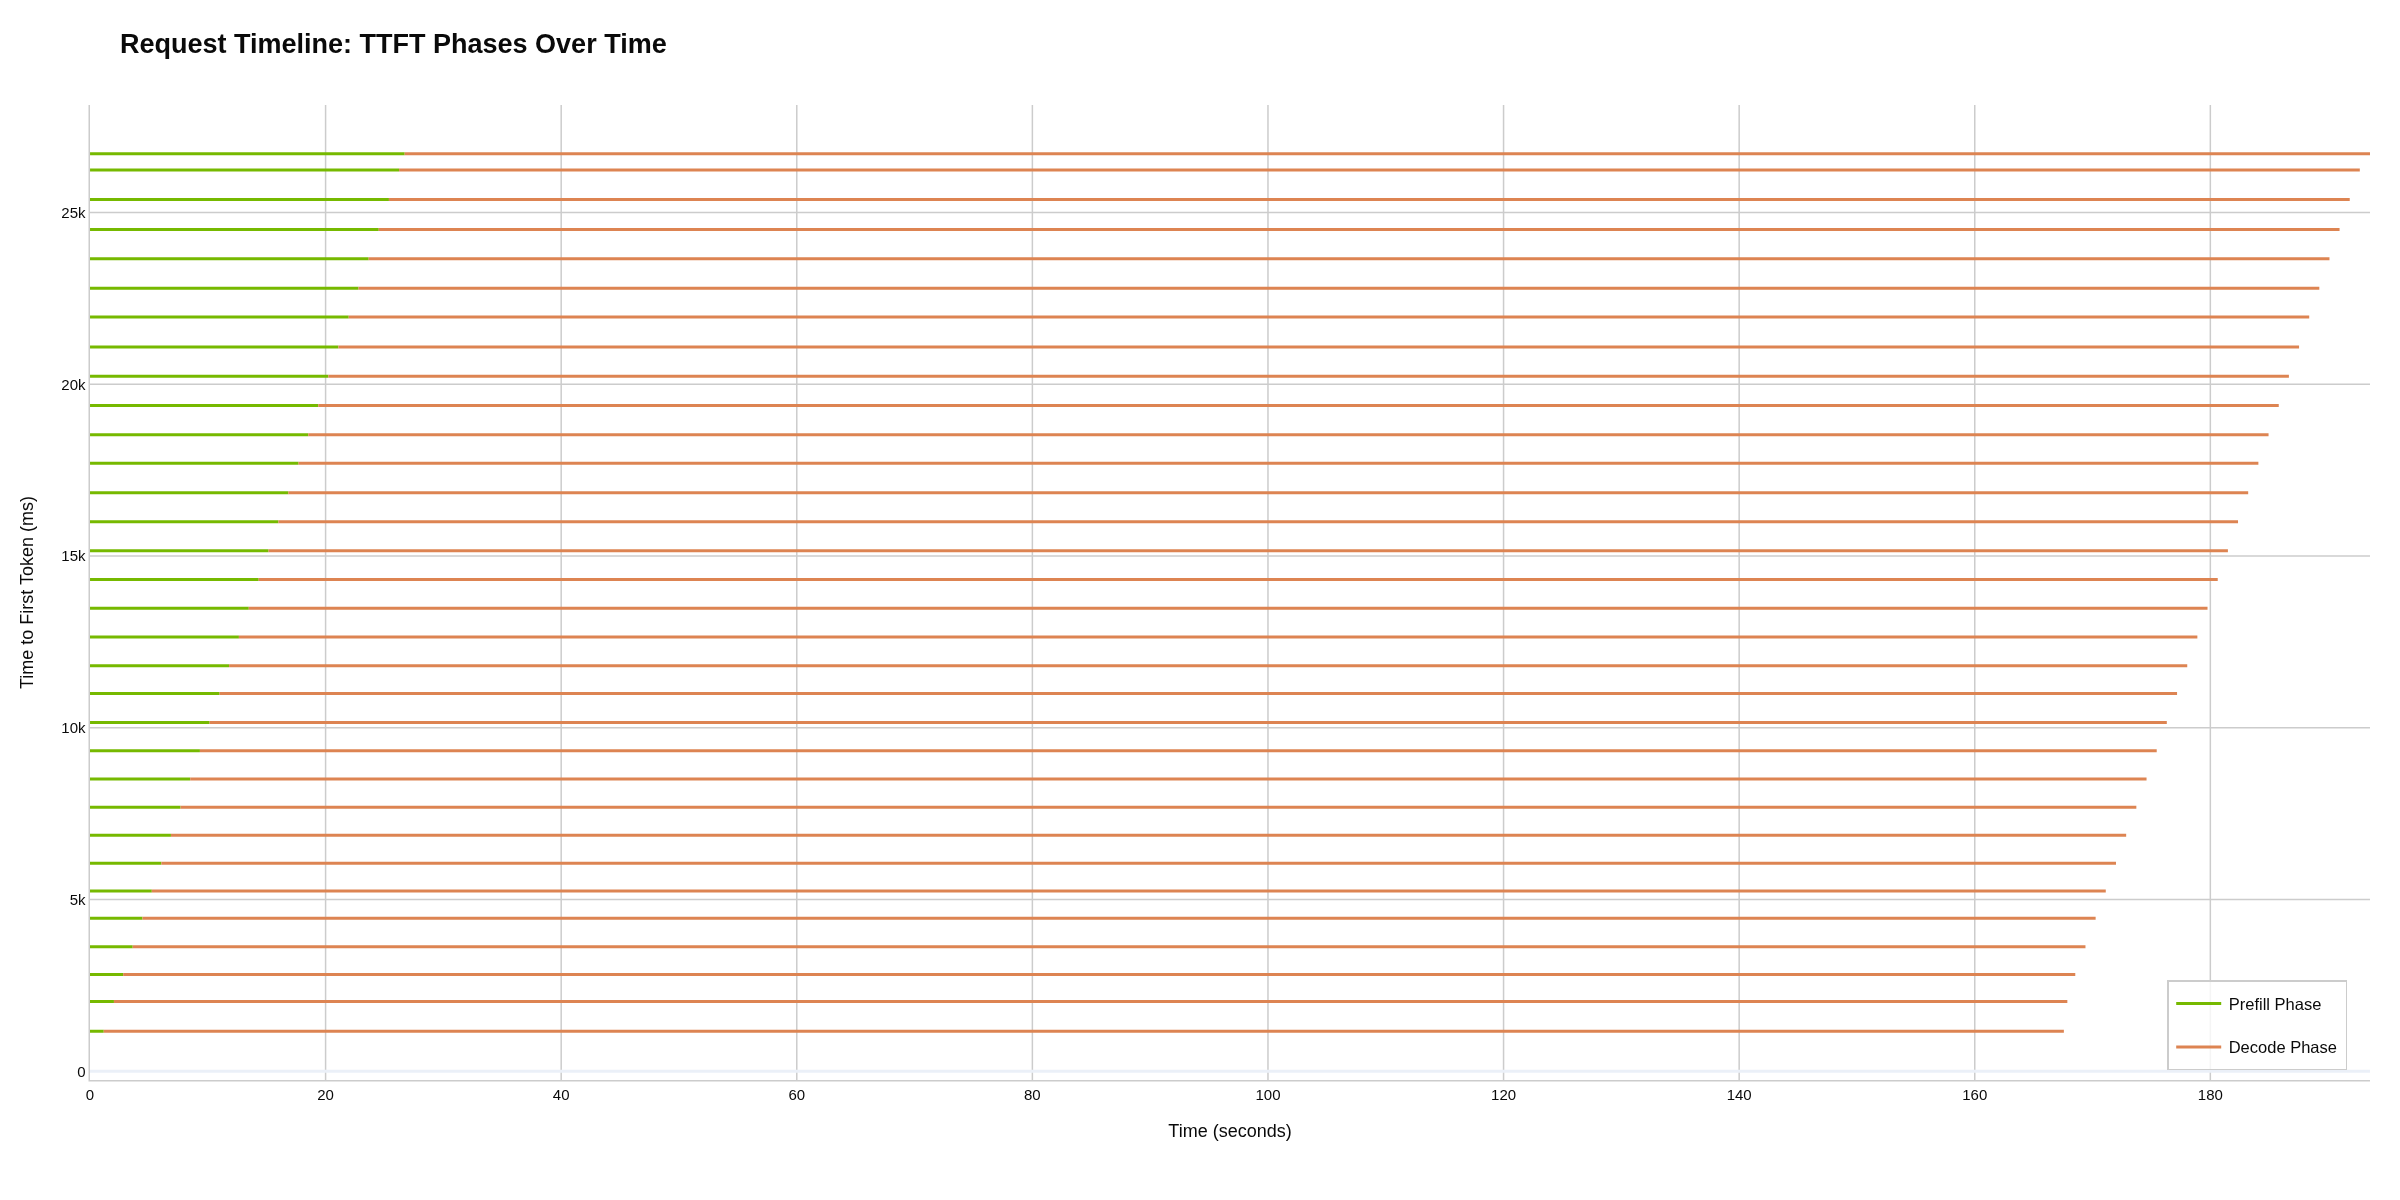
Jede Zeile ist eine Anfrage: grün, bis der erste Token vorhanden ist, orange, während die Antwort generiert wird.
Die FP8- und NVFP4-Versionen der dichten Modelle konnten den Gesamtdurchsatz bis zu 32 gleichzeitigen Anfragen steigern – der höchste Testwert; die eigene Zählung von vLLM zeigt 153 bis 184 Tokens pro Sekunde bei 32 Anfragen, im Gegensatz zu AIPerfs 149 bis 154.
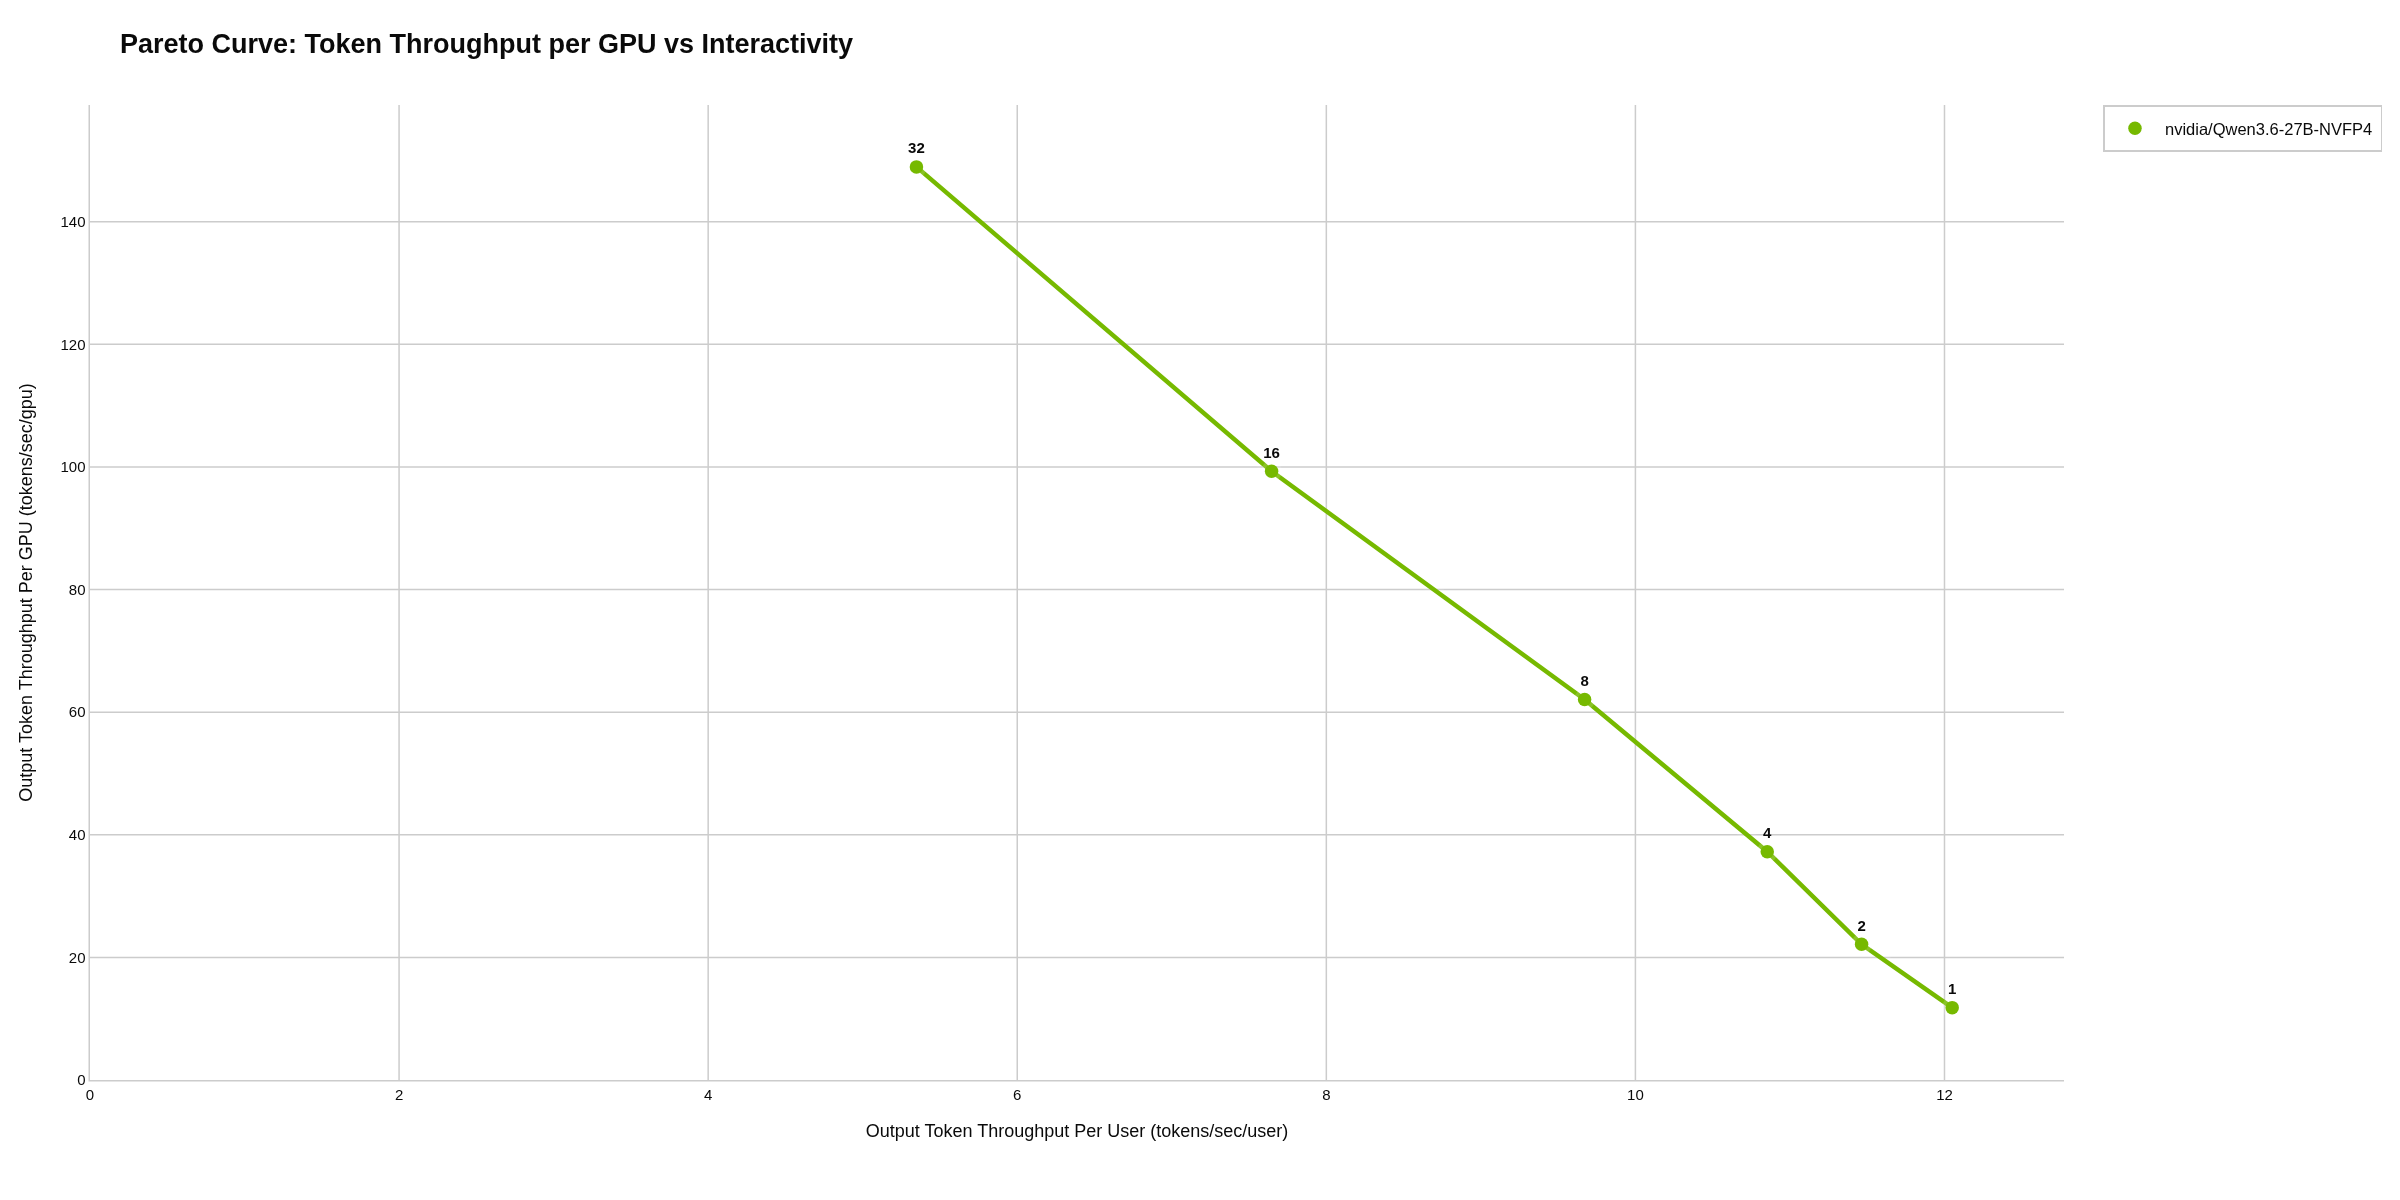
nvidia/Qwen3.6-27B-NVFP4 auf dem DGX Spark.
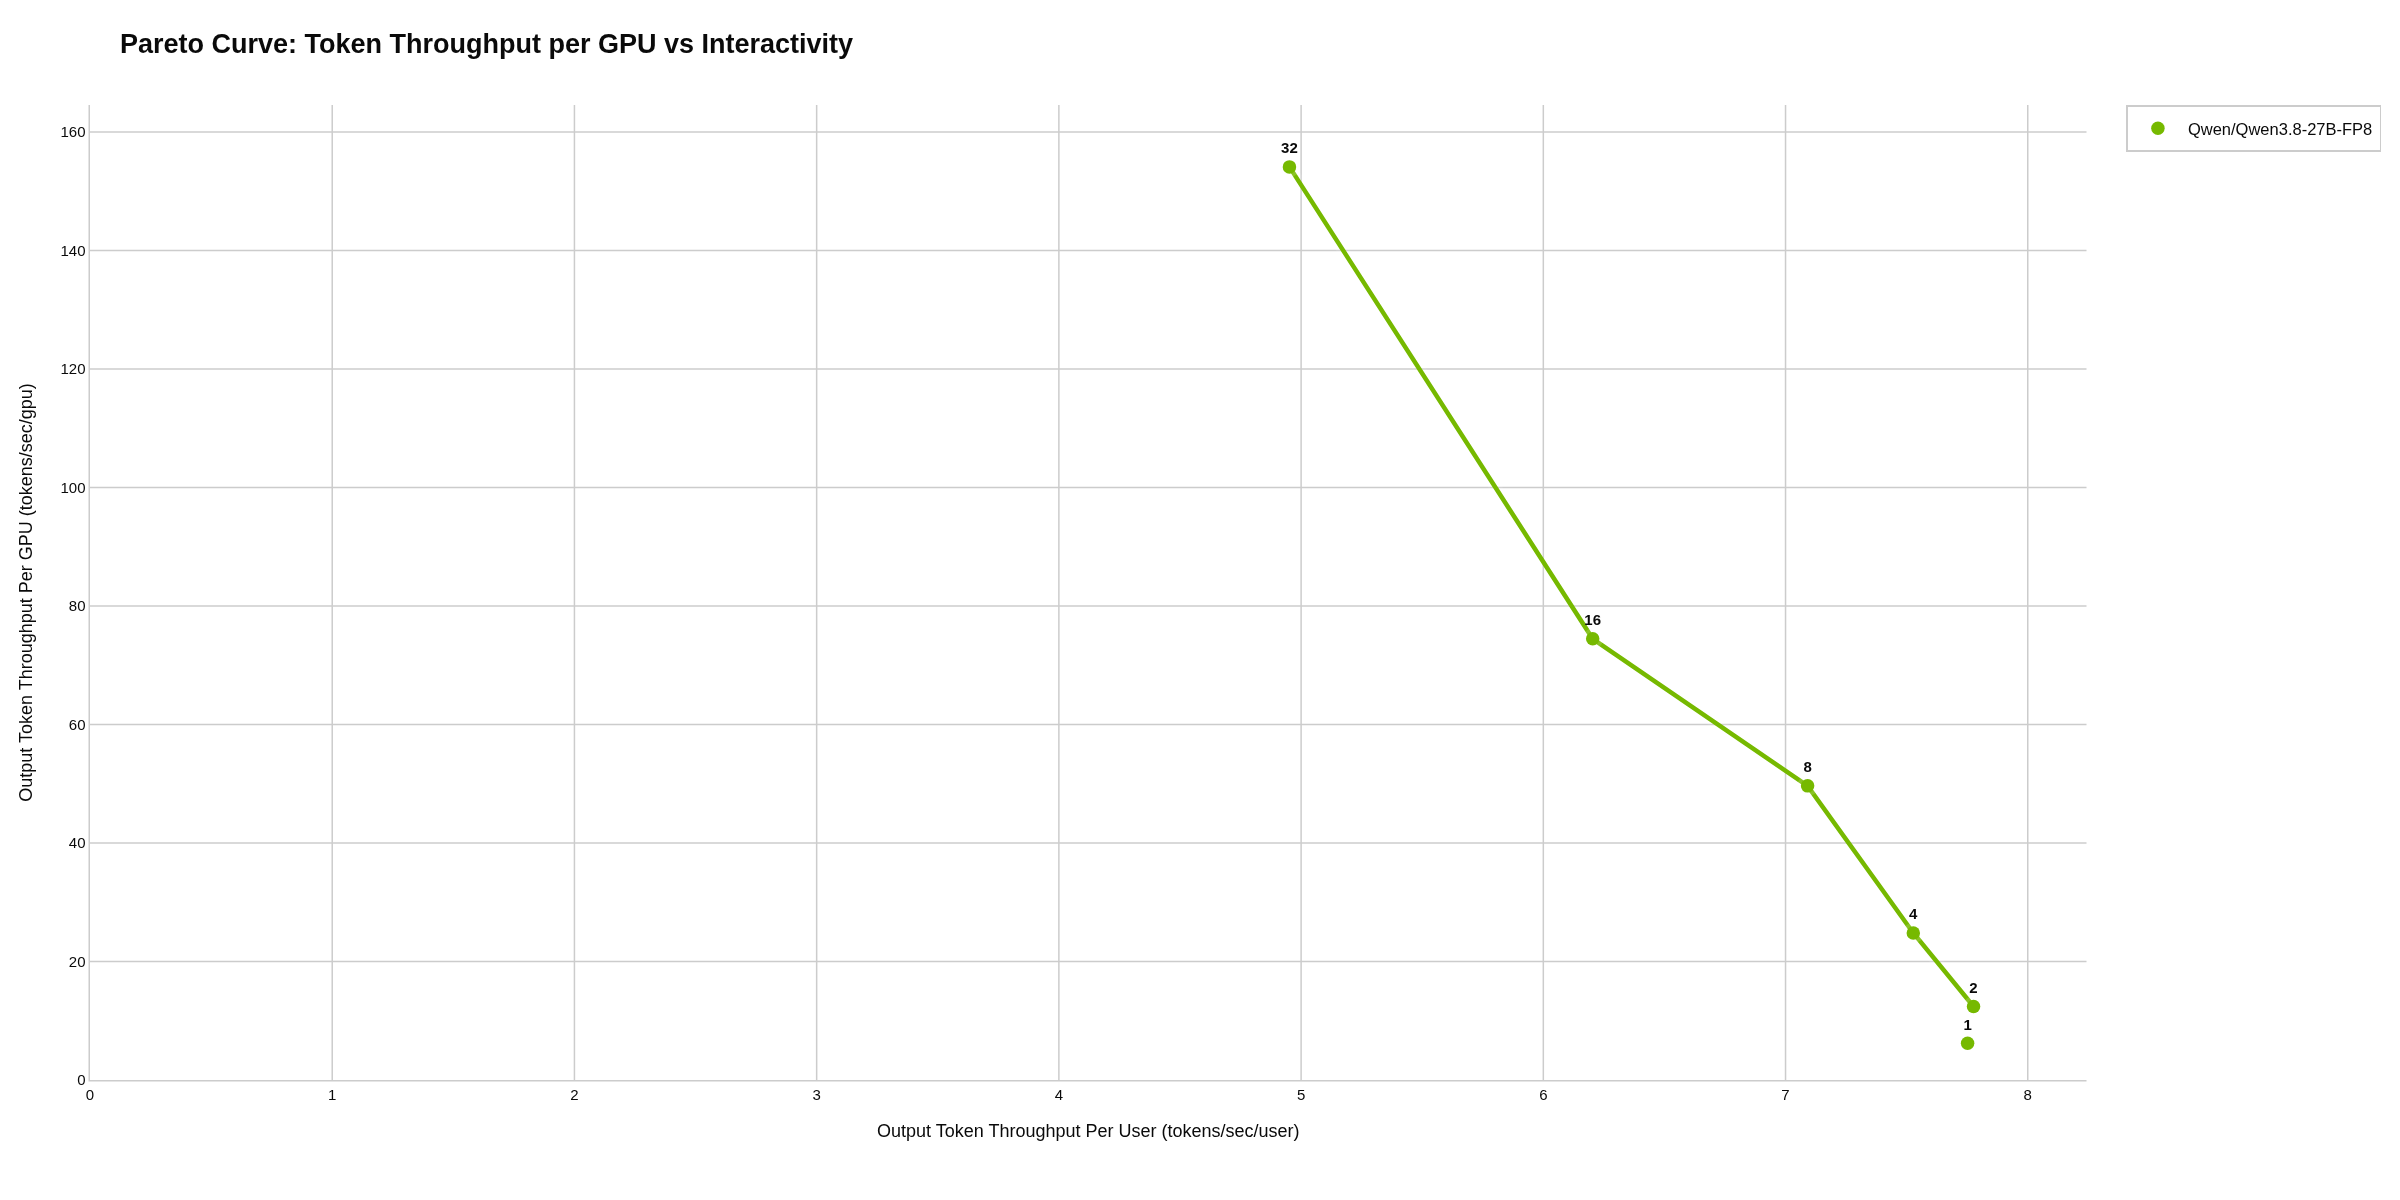
Qwen/Qwen3.8-27B-FP8 auf dem DGX Spark.
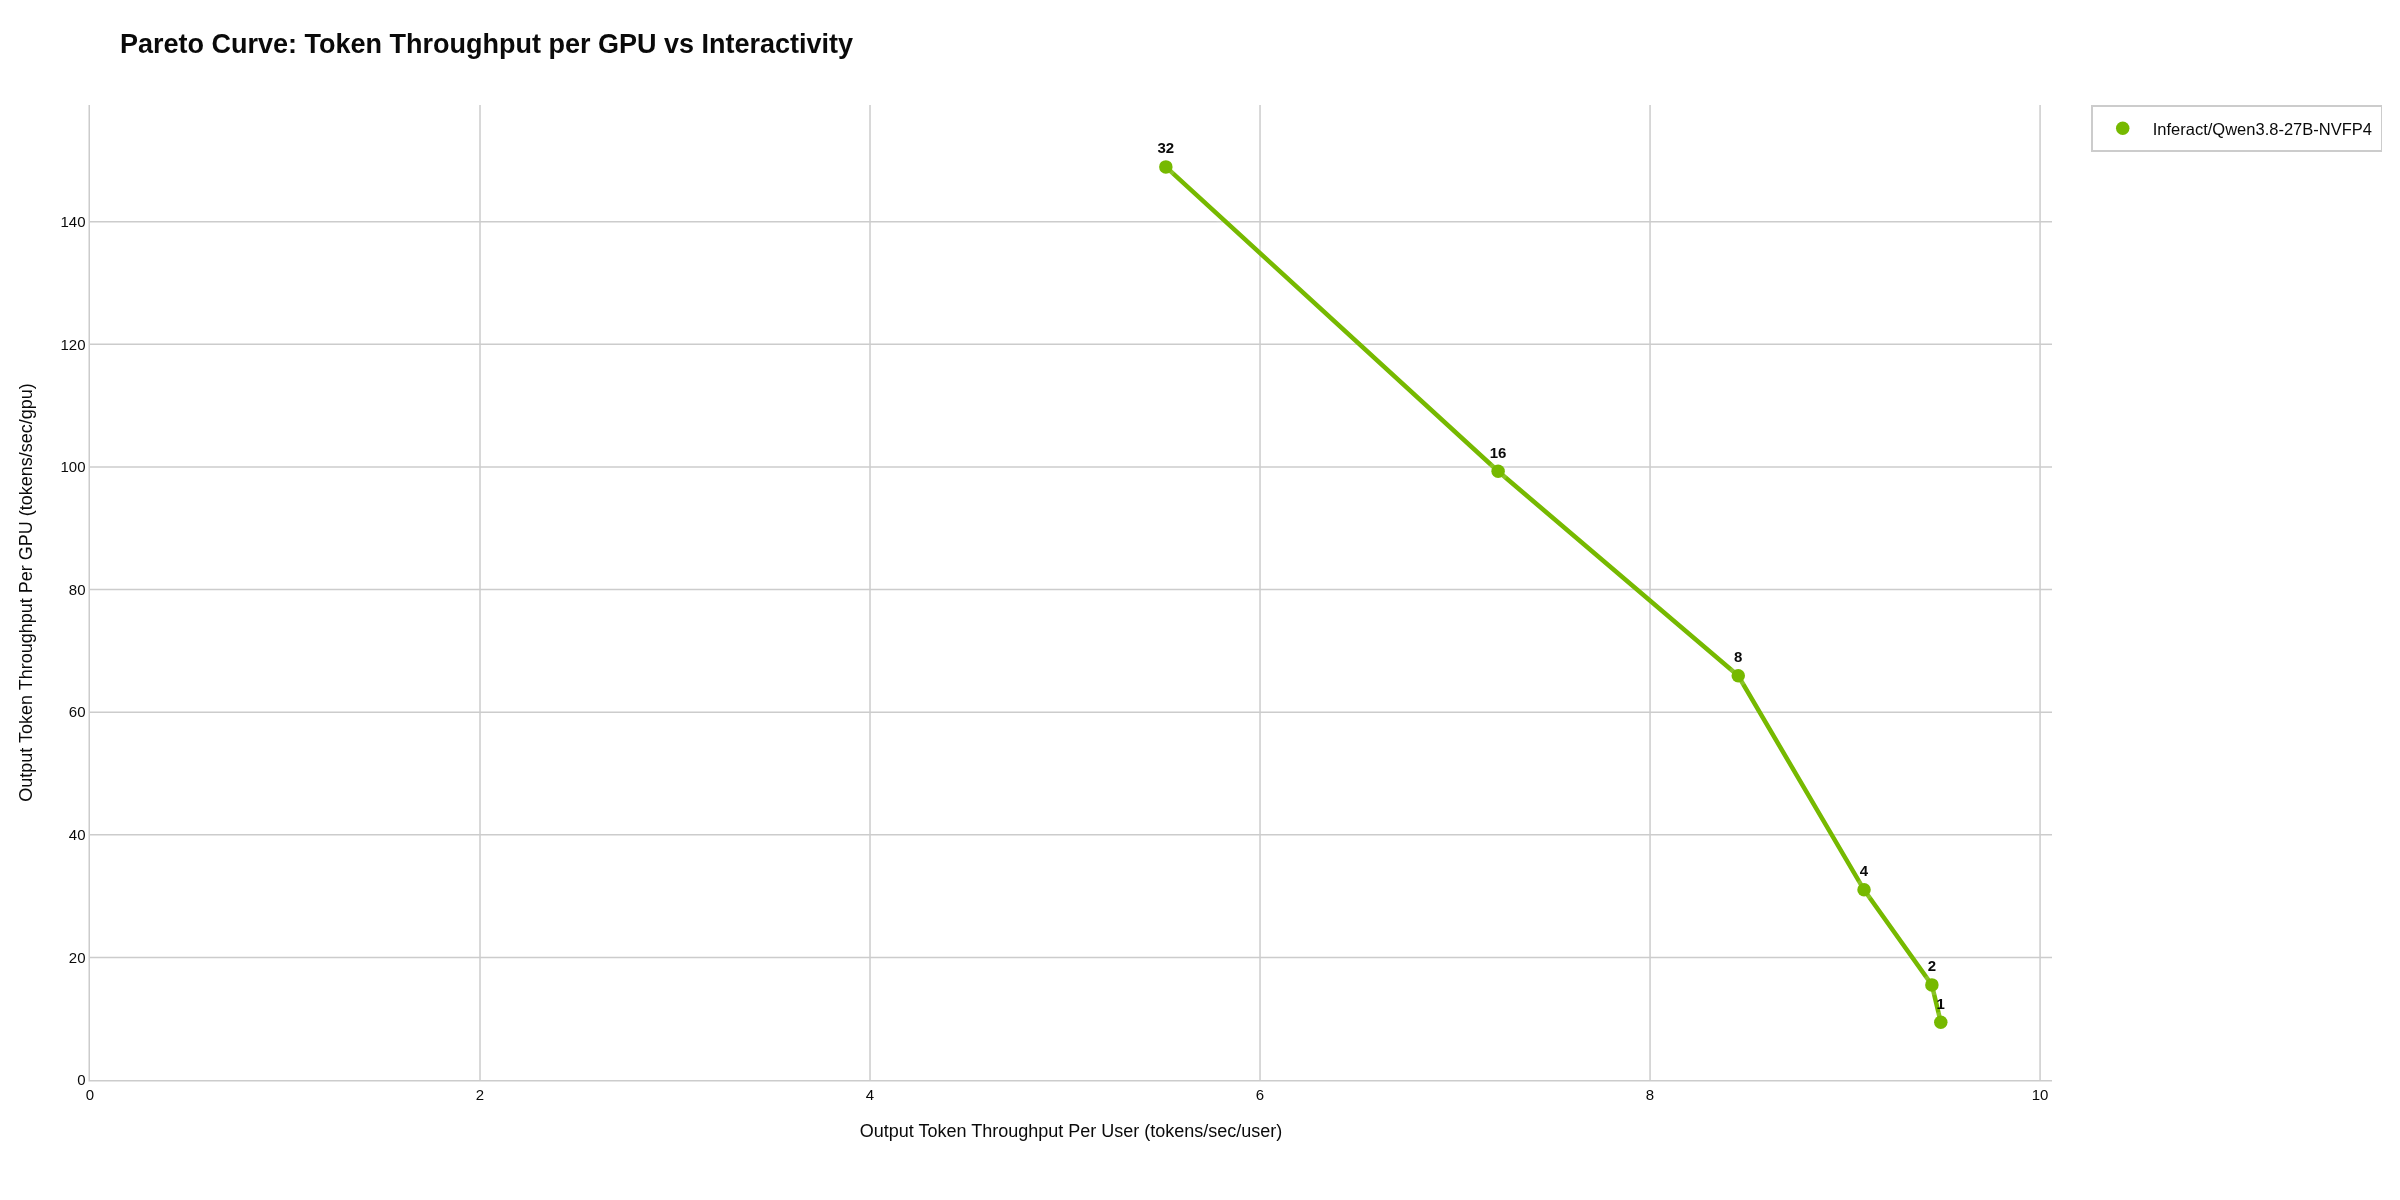
Inferact/Qwen3.8-27B-NVFP4 auf dem DGX Spark.
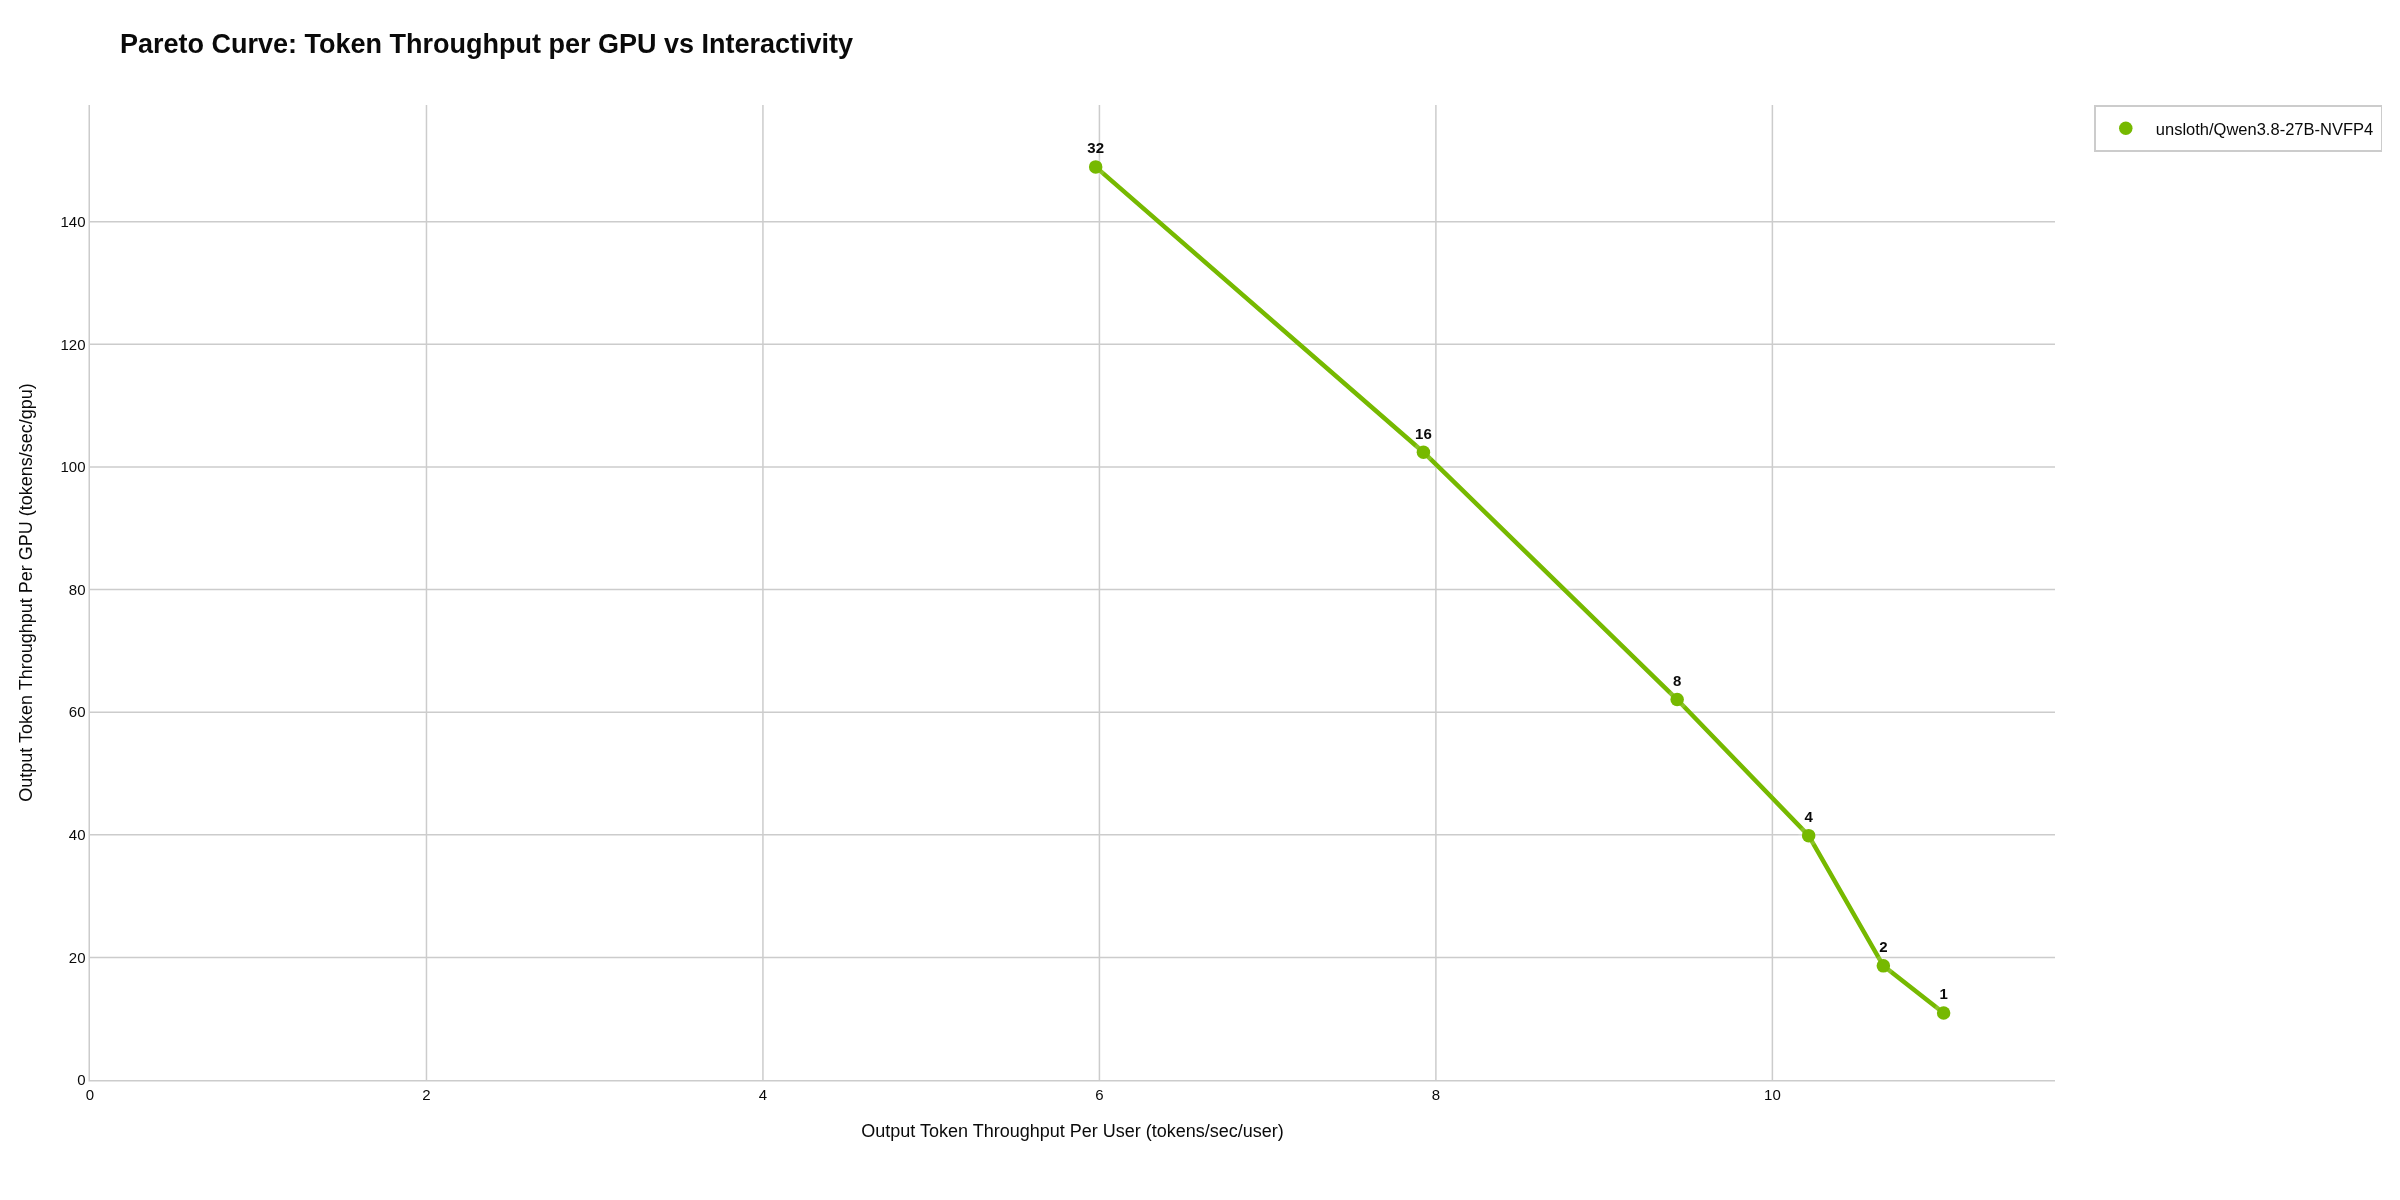
unsloth/Qwen3.8-27B-NVFP4 auf dem DGX Spark.
Gemeinsame Merkmale bei den Vergleichsindikatoren, die wir für alle 14 LLM-Modelle erhoben haben
Zwei Modelle erreichten bei der Geschwindigkeit auf dem Spark eine gute Leistung. Modelle, die weniger Parameter pro Token verwenden, waren schneller: In BF16 generierten die Mischungsverhältnisse von Experten mit 3 bis 4 Milliarden aktiven Parametern pro Sekunde 23 bis 30 Tokens pro Anfrage (gemma-4-26B-A4B-it 23,2; Qwen3.6-35B-A3B 29,8); die dichten Modelle mit 27 bis 30 B-Parameter erreichten etwa 4 Tokens pro Sekunde; und die Modelle mit niedrigerer Präzision waren schneller: In jeder Modellfamilie generierten die FP8-, NVFP4- und 4-Bit-Versionen jeweils etwa 1,8 bis 2,7 Mal so viele Tokens pro Sekunde für eine einzelne Anfrage wie ihre BF16-Originale. Die NVFP4-Version von Qwen3.6-35B-A3B von NVIDIA lief mit zwei zusätzlichen vLLM-Einstellungen (– attention-backend flashinfer, –moe-backend marlin).
Bei 16 gleichzeitigen Anfragen lieferten vier Modelle jeweils mehr als 20 Token pro Sekunde: gemma-4-E4B-it-qat-w4a16-ct (43,1), nvidia/Qwen3.6-35B-A3B-NVFP4 (22,8), nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4 (20,9) und gemma-4-E4B-it (20,2).
Grenzen dieses Spark-Benchmarking-Tests
Jede Lastebene wurde einmal auf dem Spark ausgeführt, sodass es keine Vergleichswerte mehr gibt. Ich habe bis zu 32 gleichzeitig laufende Anfragen getestet, und mit Nemotron-3-Super bis zu 16. Die Arbeitslast ist synthetisch: Die tatsächlichen Anfragen und Antworten variieren in der Länge, und andere Einstellungen oder neuere Softwareversionen können die Ergebnisse verändern. Während des gesamten Tests fiel eine Anfrage aus, eine Verbindung wurde unter 32 gleichzeitig laufenden Anfragen für unsloth/Qwen3.8-27B-NVFP4 abgebrochen.
Daten
Alle Rohdaten, Konfigurationsdateien und Diagramme sind vorhanden. aiperf_dgx_spark_260917. Jedes Modell hat seinen eigenen Ordner unter Artefakte/:
| Modell | Ordner |
|---|---|
| google/gemma-4-E4B-it | 20260912_223559_google_gemma-4-E4B-it_c1,2,4,8,16,32 |
| google/gemma-4-E4B-it-qat-w4a16-ct | 20260912_231103_google_gemma-4-E4B-it-qat-w4a16-ct_c1,2,4,8,16,32 |
| google/gemma-4-26B-A4B-it | 20260912_215931_google_gemma-4-26B-A4B-it_c1,2,4,8,16,32 |
| nvidia/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4 | 20260913_014356_nvidia_NVIDIA-Nemotron-3.5-Lightning-30B-A3B-NVFP4_c1,2,4,8,16,32 |
| nvidia/NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4 | 20260913_011257_nvidia_NVIDIA-Nemotron-3-Super-120B-A12B-NVFP4_c1,2,4,8,16 |
| ibm-granite/granite-4.2-30b | 20260912_234824_ibm-granite_granite-4.2-30b_c1,2,4,8,16,32 |
| Qwen/Qwen3.6-35B-A3B | 20260913_041606_Qwen_Qwen3.6-35B-A3B_c1,2,4,8,16,32 |
| nvidia/Qwen3.6-35B-A3B-NVFP4 | 20260913_025945_nvidia_Qwen3.6-35B-A3B-NVFP4_c1,2,4,8,16,32 |
| Qwen/Qwen3.6-27B | 20260913_033627_Qwen_Qwen3.6-27B_c1,2,4,8,16,32 |
| nvidia/Qwen3.6-27B-NVFP4 | 20260913_022142_nvidia_Qwen3.6-27B-NVFP4_c1,2,4,8,16,32 |
| Qwen/Qwen3.8-27B | 20260913_045827_Qwen_Qwen3.8-27B_c1,2,4,8,16,32 |
| Qwen/Qwen3.8-27B-FP8 | 20260913_053908_Qwen_Qwen3.8-27B-FP8_c1,2,4,8,16,32 |
| Inferact/Qwen3.8-27B-NVFP4 | 20260913_002824_Inferact_Qwen3.8-27B-NVFP4_c1,2,4,8,16,32 |
| unsloth/Qwen3.8-27B-NVFP4 | 20260913_061847_unsloth_Qwen3.8-27B-NVFP4_c1,2,4,8,16,32 |
Die genauen vLLM-Einstellungen für jedes Modell sind in conf/model_compose_overrides/.
Wenn Sie den DGX Spark für ein bestimmtes Modell oder eine bestimmte Anwendung evaluieren, würden wir uns freuen, Ihre Anforderungen zu hören. Wir können Ihr Modell anhand Ihrer eigenen Anweisungen und Längen der Antworten vergleichen und Ihnen helfen, zu beurteilen, was die Ergebnisse für Ihren Anwendungsfall bedeuten.
 Deutsch (Sie)
 English